Data Science lifecycle 101: yangi boshlovchilar uchun mukammal qo'llanma
Data Science lifecycle'ni bosqichma-bosqich o'rganing: yangi boshlovchilar uchun mo'ljallangan ushbu qo'llanmada asosiy bosqichlar, vositalar va texnikalar bilan tanishing.
Muallif: Fernando Doglio
Data science loyihasini boshidan to production'gacha ishlab chiqish oddiy ish emas. U shunchalik ko'p qadamlar va murakkab vazifalarni o'z ichiga oladiki, aniq qoidalar va cheklovlarsiz production'ga release qilish o'n barobar qiyinlashadi.
Aynan shu yerda data science lifecycle yordamga keladi. U tuzilmali yondashuvni taqdim etadi, shunda data scientist'lar, data analyst'lar va boshqalar xom ma'lumotlardan amaliy xulosalargacha birgalikda harakatlana oladi.
Ushbu qo'llanmada data science lifecycle, uning ko'plab variantlari va loyihangiz uchun to'g'risini qanday tanlash haqida bilishingiz kerak bo'lgan hamma narsani ko'rib chiqamiz.
Qani, boshladik!
Lifecycle'ning asosiy tushunchalari
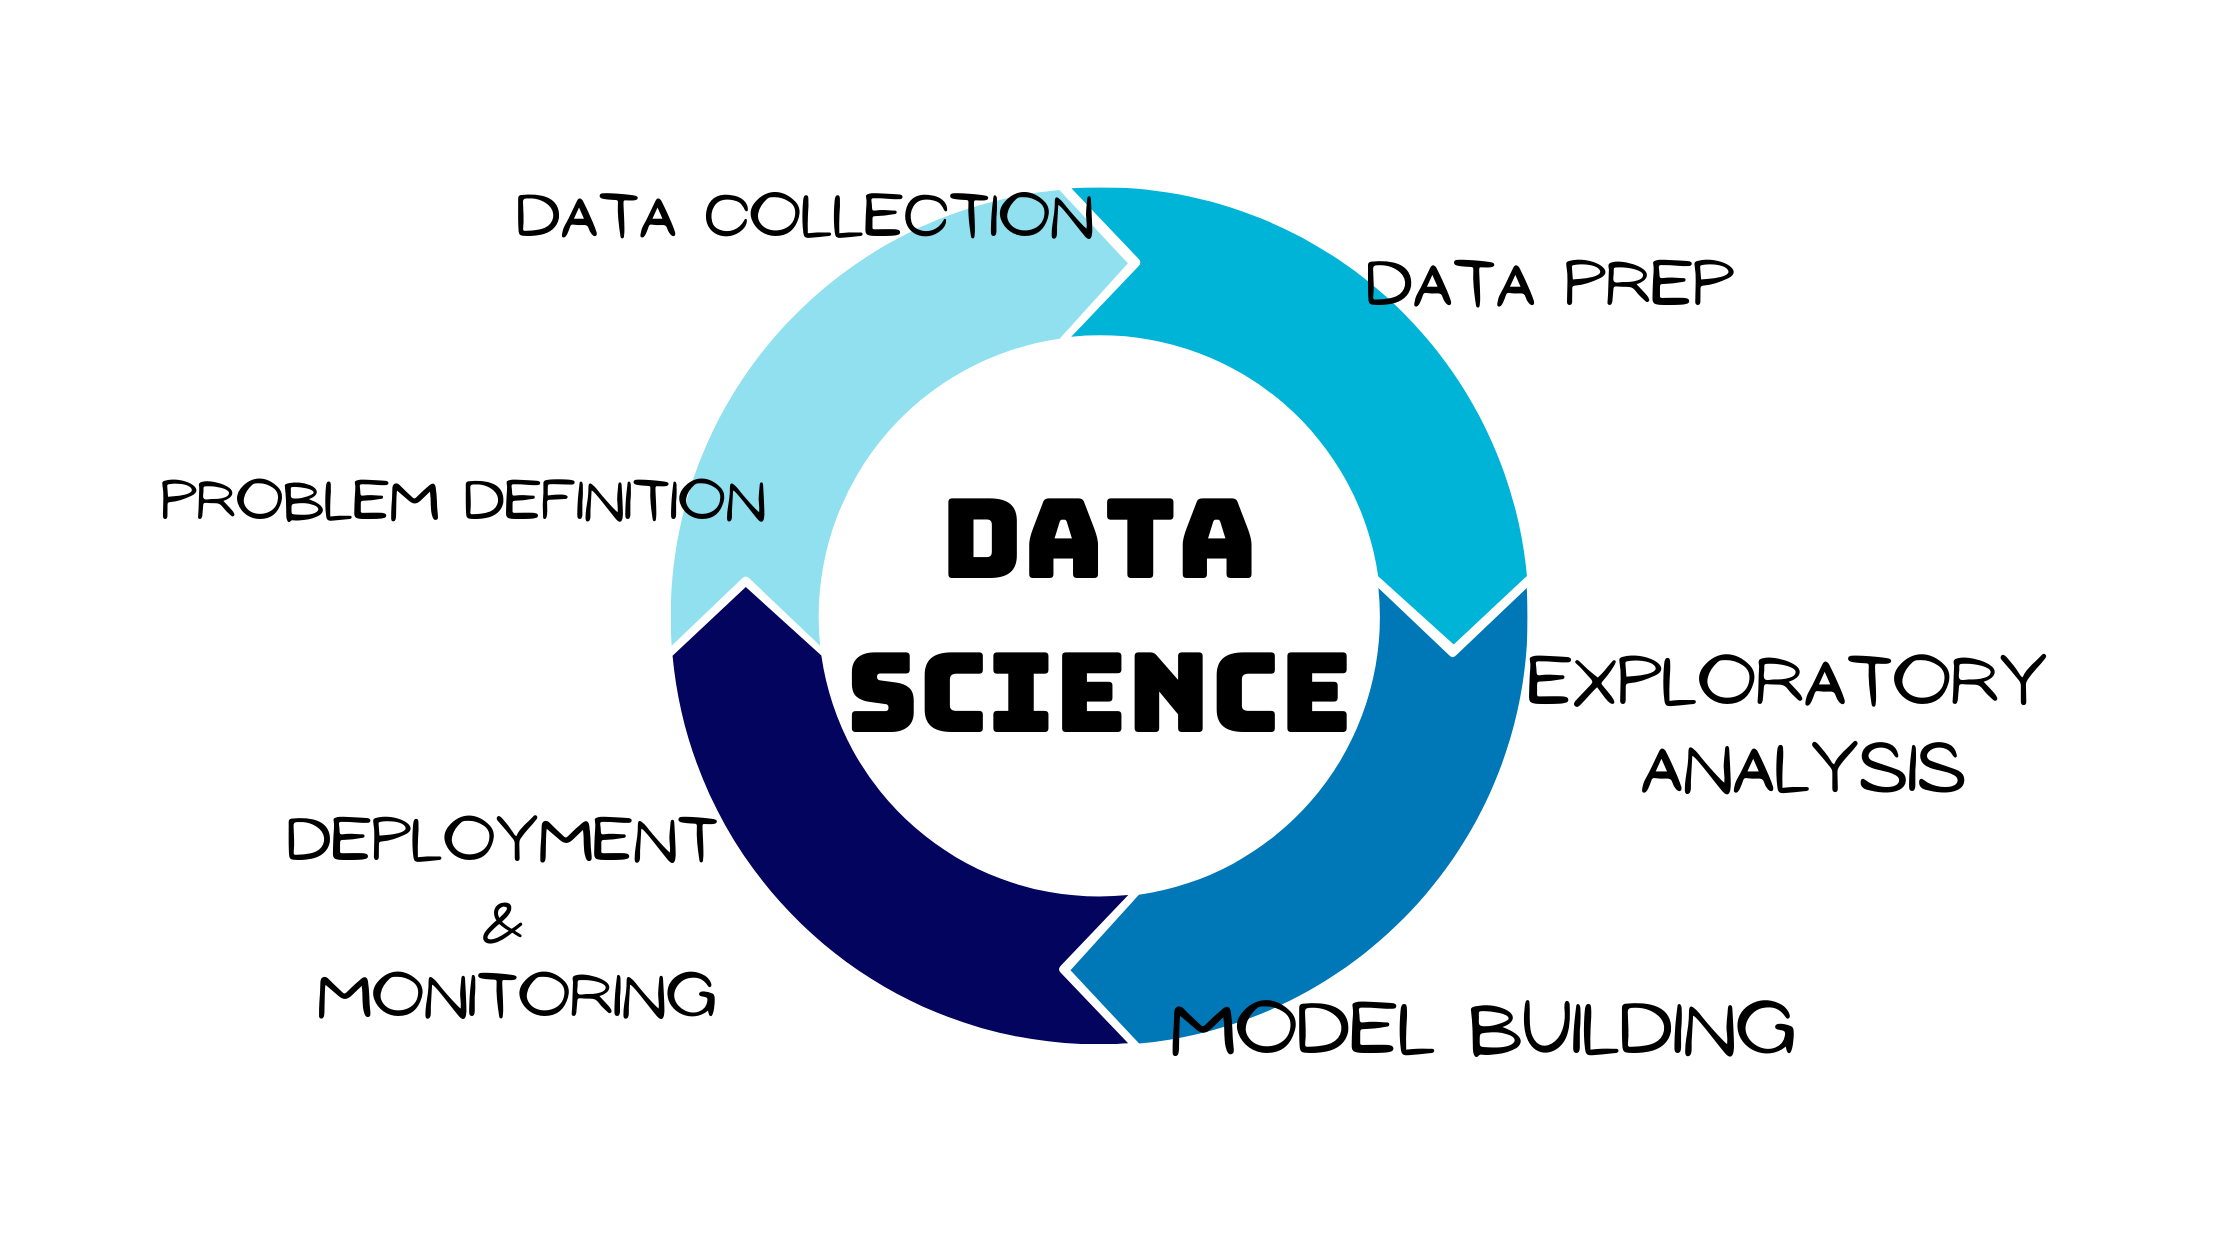
Lifecycle tushunchasini to'liq anglash uchun ushbu freymvork ichidagi asosiy tushunchalarni va ularning muvaffaqiyatli data science loyihasini yetkazib berishga qanday hissa qo'shishini ko'rib chiqishimiz kerak.
Muammoni aniqlash
Har bir data science loyihasi hal qilinishi kerak bo'lgan muammoni aniq belgilashdan boshlanadi. Bu maqsadlar va kutilgan natijalarni aniqlash uchun asosiy stakeholder'lar bilan hamkorlik qilishni o'z ichiga oladi. Maqsadlar biznes yoki tadqiqot ehtiyojlariga mos kelishini ta'minlash uchun data scientist'lar loyihaning kontekstini va ko'lamini tushunishi kerak.
Ma'lumotlarni yig'ish
Ma'lumotlarni yig'ish bosqichida data scientist'lar va data engineer'lar birgalikda ishlaydi hamda turli ma'lumot manbalaridan tegishli ma'lumotlarni to'playdi. Bunga structured va unstructured data, masalan, tarixiy yozuvlar, yangi ma'lumotlar yoki data stream'lar kiradi.
Bu jarayon barcha tegishli ma'lumotlarning integratsiyasini ta'minlaydi va keyingi bosqichlar uchun mustahkam dataset yaratadi. Bu bosqichda data acquisition vositalari va strategiyalari muhim rol o'ynaydi.
Ma'lumotlarni tayyorlash
Bu bosqich xom ma'lumotlarni tahlil uchun tozalash va tartibga solish orqali ularning sifati bilan shug'ullanadi. Noto'g'ri ma'lumotlarga ishlov berish, missing value'larni bartaraf etish va xom ma'lumotlarni foydalanish mumkin bo'lgan formatlarga o'tkazish kabi vazifalar bu bosqichning markazida turadi. Bu bosqich ma'lumotlarni keyingi, yanada batafsil tahlilga tayyorlaydi.
Exploratory Data Analysis (EDA)
Exploratory data analysis bosqichida "data processing" amalga oshiriladi. Bu bosqich ma'lumotlar ichidagi qonuniyatlar, trend'lar va o'zaro bog'liqliklarni aniqlashga qaratilgan. Bar graph'lar kabi data visualization texnikalari va statistik modellar orqali data scientist'lar ma'lumotlarni puxta tahlil qiladi hamda ma'lumotlarning tuzilishi va xususiyatlari haqida chuqur tushuncha hosil qiladi.
Hozirgacha ko'rilgan har bir bosqich kabi, bu bosqich ham keyingi bosqichlar uchun poydevor yaratadi. Aynan bu holatda batafsil EDA o'tkazilgandan so'ng, data scientist'lar ishlashlari kerak bo'lgan ma'lumotlarni ancha yaxshi tushunadi va endi ular bilan nima qilish mumkinligi haqida ancha aniq tasavvurga ega bo'ladi.
Modelni qurish va baholash
Model building bosqichi aniqlangan muammoga moslashtirilgan predictive yoki machine learning modellarini ishlab chiqishni o'z ichiga oladi. Data scientist'lar eng yaxshi yondashuvni aniqlash uchun turli machine learning algoritmlari va statistik modellar bilan tajriba o'tkazadi. Aynan shu yerda data modeling amalga oshiriladi: u exploratory data analysis (EDA) bosqichida olingan xulosalarni deployment bosqichida ishlatiladigan amaliy bashoratlar va natijalar bilan bog'laydi.
Shundan so'ng model evaluation keladi: bunda modellarning ishonchliligini ta'minlash uchun ularning samaradorligi va aniqligi tekshiriladi.
Deployment va monitoring
Ushbu umumiy data science lifecycle'ning so'nggi bosqichi modelni production muhitiga deploy qilishni o'z ichiga oladi. Bu yerda data scientist'lar, machine learning engineer'lar va quality assurance jamoalari modelning mavjud dasturiy tizimlar ichida samarali ishlashini ta'minlaydi.
Bu bosqichdan keyin yangi ma'lumotlar yoki o'zgaruvchan sharoitlarga moslashish uchun doimiy monitoring va maintenance zarur, chunki ular modelning samaradorligi va aniqligiga ta'sir qilishi mumkin.
6 ta mashhur lifecycle variantini o'rganamiz
Data science lifecycle muayyan ehtiyojlar va kontekstlarga moslashtirilgan turli freymvorklarni taklif qiladi. Quyida oltita taniqli variantni ko'rib chiqamiz:
CRISP-DM (Cross Industry Standard Process for Data Mining)
CRISP-DM — data science loyihalarida, ayniqsa biznes kontekstida eng keng qo'llaniladigan freymvorklardan biri.
U lifecycle'ni oltita bosqichga ajratadi: Business Understanding, Data Understanding, Data Preparation, Modeling, Evaluation va Deployment.
Bu iterativ yondashuv jamoalarga yangi xulosalar paydo bo'lishi bilan oldingi qadamlarga qaytish va ularni takomillashtirish imkonini beradi. CRISP-DM texnik sa'y-harakatlarni biznes maqsadlari bilan uyg'unlashtirish juda muhim bo'lgan loyihalar uchun ideal.
Qo'llanish misoli: Chakana savdo kompaniyasi maqsadli marketing kampaniyalari uchun customer segmentation'ni yaxshilamoqchi. CRISP-DM'dan foydalanib, jamoa segmentatsiya maqsadlarini belgilash uchun business understanding'dan boshlaydi, tranzaksiya va demografik ma'lumotlarni yig'adi, ularni tayyorlaydi va tozalaydi, clustering modellarini quradi, ularning samaradorligini baholaydi va mijozlarni shaxsiylashtirilgan takliflar uchun guruhlash maqsadida eng yaxshi modelni deploy qiladi.
KDD (Knowledge Discovery in Databases)
KDD jarayoni katta dataset'lardan foydali bilimlarni ajratib olishga qaratilgan. Uning bosqichlari Selection, Preprocessing, Transformation, Data Mining va Interpretation/Evaluation'dan iborat.
KDD data science'ning akademik va tadqiqotga yo'naltirilgan jihatlariga urg'u beradi, bu esa uni ilmiy sohalardagi eksperimental yoki tadqiqiy loyihalar uchun ideal tanlovga aylantiradi. U murakkab dataset'lardagi qonuniyatlar va xulosalarni kashf qilishga tizimli yondashuvni taklif qiladi.
Qo'llanish misoli: Ilmiy-tadqiqot instituti iqlim qonuniyatlarini o'rganish uchun sun'iy yo'ldosh ma'lumotlarini tahlil qiladi. Ular KDD'ga amal qilib, tegishli dataset'larni tanlaydi, shovqinni olib tashlash uchun preprocessing qiladi, mavsumiy trend'larni ko'rsatish uchun ma'lumotlarni transformatsiya qiladi, uzoq muddatli iqlim o'zgarishlarini aniqlash uchun data mining texnikalarini qo'llaydi va topilmalarni e'lon qilish uchun natijalarni talqin qiladi.
Data Analytics Lifecycle
Ushbu data science lifecycle amaliy xulosalarni ustuvor biladigan korporativ darajadagi loyihalar uchun moslashtirilgan. U oltita bosqichdan iborat: Discovery, Data Preparation, Model Planning, Model Building, Communicating Results va Operationalizing.
Freymvorkning kuchli tomonlari uning biznes maqsadlariga mosligi va model deployment'ga tayyorligida, bu esa uni data-driven yechimlarni o'z faoliyatiga integratsiya qilmoqchi bo'lgan tashkilotlar uchun ideal qiladi.
Qo'llanish misoli: Moliya muassasasi firibgarlik tranzaksiyalarini aniqlash uchun Data Analytics Lifecycle'dan foydalanadi. Ular tarixiy tranzaksiya ma'lumotlaridagi qonuniyatlarni aniqlaydi, ularni tozalash va normallashtirish orqali tayyorlaydi, predictive modellarni rejalashtiradi, ularni quradi va test qiladi, natijalarni firibgarlikning oldini olish jamoalariga yetkazadi va real vaqtdagi tranzaksiyalarni kuzatish uchun modelni operatsion jarayonga joriy qiladi.
SEMMA (Sample, Explore, Modify, Model, Assess)
SEMMA — SAS tomonidan ishlab chiqilgan, sodda va vositaga yo'naltirilgan freymvork. U ma'lumotlarni sampling qilish, ularni qonuniyatlarni topish uchun o'rganish, tahlilga moslab o'zgartirish, bashoratlar uchun modellashtirish va natijalarni baholashga qaratilgan.
Bu lifecycle ayniqsa muayyan analytics vositalari bilan bog'liq workflow'lar uchun foydali. Uning soddaligi va data exploration'ga kuchli urg'u berishi uni tezkor xulosalarni ustuvor biladigan jamoalar uchun ajoyib tanlovga aylantiradi.
Qo'llanish misoli: Sog'liqni saqlash tashkiloti SEMMA yordamida bemorlarning qayta kasalxonaga yotqizilish darajasini bashorat qiladi. Ular shifoxona yozuvlaridan ma'lumotlar namunasini oladi, trend'larni topish uchun bemorlar tarixini o'rganadi, bemor yoshi va tashxislar kabi feature'larni o'zgartiradi, machine learning modellarini quradi va eng samarali predictor'ni tanlash uchun ularning aniqligini baholaydi.
Team Data Science Process (TDSP)
TDSP lifecycle'ni to'rtta asosiy bosqichga ajratadigan, hamkorlikka asoslangan agile freymvorkni taklif qiladi: Business Understanding, Data Acquisition, Modeling va Deployment.
Jamoaviy workflow'larni hisobga olgan holda ishlab chiqilgan TDSP iterativ rivojlanish va moslashuvchanlikka urg'u beradi, bu esa loyihalarning o'zgarishlarga moslashuvchan bo'lib qolgan holda biznes ehtiyojlariga mos kelishini ta'minlaydi. U data scientist'lar, muhandislar va stakeholder'lar o'rtasida yaqin hamkorlikni talab qiladigan holatlar uchun juda mos keladi.
Qo'llanish misoli: Logistika kompaniyasi yetkazib berish marshrutlarini optimallashtirishni yaxshilaydi. TDSP'dan foydalangan holda jamoa biznes maqsadlarini tushunish uchun hamkorlik qiladi, GPS va transport harakati tizimlaridan ma'lumotlar oladi, marshrutlash modellarini ishlab chiqadi va eng tez yetkazib berish marshrutlarini dinamik ravishda taklif qilish uchun ularni deploy qiladi.
MLOps Lifecycle
MLOps aynan machine learning operatsiyalari va production muhitlariga qaratilgan. Uning bosqichlari Data Engineering, Model Development, Model Deployment va Monitoring'dan iborat.
Bu lifecycle yuqori scalability va avtomatlashtirishni talab qiladigan katta ko'lamli machine learning tizimlari bilan bog'liq loyihalar uchun juda muhim.
MLOps continuous integration va delivery pipeline'lari bilan muammosiz integratsiyalashadi, bu esa yangi ma'lumotlar kiritilgani sari deploy qilingan modellarning samarali va dolzarb bo'lib qolishini ta'minlaydi.
Bu freymvorklarning har biri o'zining kuchli tomonlariga ega va data science operatsiyalarining turli turlariga mos keladi.
Qo'llanish misoli: E-commerce platformasi MLOps yordamida recommendation engine'ni deploy qiladi. Ular foydalanuvchi faolligi log'laridan data pipeline'larini quradi, collaborative filtering modellarini ishlab chiqadi, ularni veb-saytga deploy qiladi va yangi foydalanuvchi ma'lumotlari qo'shilganda modellarni retrain qilish uchun ularning samaradorligini kuzatib boradi.
To'g'ri data science lifecycle'ni qanday tanlash kerak
Data science loyihangiz uchun eng mos data science lifecycle'ni aniqlash tizimli yondashuvni talab qiladi. Axir, barcha lifecycle'lar ham barcha vaziyatlarga birdek mos kelavermaydi.
Maqsadlaringiz va resurslaringizga eng mos keladigan freymvorkni aniqlash uchun quyidagi qadamlarga amal qilishingiz mumkin:
-
Maqsadlaringizni belgilang: Loyihangiz maqsadlarini aniq belgilang. Biznes muammosini hal qilyapsizmi, akademik tadqiqot o'tkazyapsizmi yoki machine learning modelini deploy qilyapsizmi? Yakuniy maqsadni tushunish tanlov doirangizni toraytiradi.
-
Loyiha murakkabligini baholang: Loyihangizning ko'lami va murakkabligini baholang. Oddiy loyihalarga SEMMA kabi soddalashtirilgan freymvorklar foyda keltirishi mumkin, iterativ talablarga ega murakkab loyihalarga esa CRISP-DM yoki TDSP kerak bo'lishi mumkin.
-
Jamoangiz tarkibini baholang: Jamoangizdagi tajriba va bilimlarni hisobga oling. Machine learning ko'nikmalari kuchli bo'lgan jamoa MLOps'dan foyda ko'rishi mumkin, turli tajriba darajasidagi a'zolardan iborat xilma-xil jamoa esa CRISP-DM kabi umumiyroq freymvorkni afzal ko'rishi mumkin.
-
Soha va domen talablarini tahlil qiling: Turli sohalar o'ziga xos ehtiyojlarga ega bo'lishi mumkin. Masalan, biznesga yo'naltirilgan loyihalar ko'pincha Data Analytics Lifecycle'ga mos keladi, akademik loyihalar uchun esa KDD ko'proq mos bo'lishi mumkin.
-
Mavjud vositalar va resurslarni ko'rib chiqing: Sizda mavjud vositalar, dasturiy ta'minot va infratuzilma tanlagan lifecycle'ingiz bilan mos kelishiga ishonch hosil qiling. SEMMA kabi freymvorklar SAS kabi maxsus vositalarni talab qilishi mumkin.
-
Asosiy stakeholder'lar ehtiyojlariga moslang: Lifecycle'ni stakeholder'larning kutishlari va talablariga moslang. TDSP kabi hamkorlikka asoslangan freymvork biznes hamkorlari bilan tez-tez fikr almashish va iteratsiyani talab qiladigan loyihalar uchun ideal bo'lishi mumkin.
-
Sinov bosqichini o'tkazing: Iloji bo'lsa, tanlangan freymvork bilan kichikroq loyihani yoki joriy loyihangizning bir qismini sinab ko'ring. Bu uning samaradorligini baholashga va kerak bo'lganda o'zgartirishlar kiritishga yordam beradi.
Ushbu qadamlarga amal qilsangiz, nafaqat loyihangizga mos keladigan, balki data science jarayoningiz samarali va unumli bo'lishini ham ta'minlaydigan lifecycle'ni aniqlay olasiz. Har bir loyiha o'ziga xos, shuning uchun lifecycle'ni uning maxsus talablariga moslashtirish muvaffaqiyat uchun hal qiluvchi ahamiyatga ega.
Yangi boshlovchilar uchun umumiy freymvork
Data science lifecycle'lari va data science loyihalariga yondashish usullari ko'p bo'lsa-da, agar endigina boshlayotgan bo'lsangiz va birinchi loyihangizni production'ga chiqarishga harakat qilayotgan bo'lsangiz, yangi boshlovchilar uchun qulay lifecycle'ga tayanish yaxshiroq fikr bo'lishi mumkin.
Data science'dagi yangi boshlovchilar uchun umumiy freymvork lifecycle'ni boshqarish oson bo'lgan qadamlarga soddalashtiradi, bu esa uni tushunish va amalga oshirishni osonlashtiradi. Yangi freymvorkingizni belgilash uchun quyidagi qadamlarga amal qilishingiz mumkin:
1. Muammoni aniqlang
Hal qilmoqchi bo'lgan muammoingizni aniq belgilashdan boshlang. Erishmoqchi bo'lgan maqsad va natijalarni ko'rib chiqing va ular har qanday stakeholder ehtiyojlariga mos kelishiga ishonch hosil qiling. Bu ishlab chiqish jarayonida sa'y-harakatlaringizni bir nuqtaga jamlashga va stakeholder'laringizda to'g'ri kutishlarni shakllantirishga yordam beradi.
2. Ma'lumotlarni yig'ing va tozalang
Ishonchli va tegishli manbalardan ma'lumotlar to'plang. Bu bosqichda noto'g'ri ma'lumotlarga ishlov berish, missing value'larni to'ldirish, ehtimoliy data bias'larni tekshirish va olib tashlash hamda nihoyat, xom ma'lumotlarni foydalanish mumkin bo'lgan formatlarga o'tkazish orqali ma'lumotlar sifatini ta'minlashga e'tibor qarating.
3. Tahlil qiling va vizuallashtiring
Qonuniyatlar, trend'lar va xulosalarni aniqlash uchun ma'lumotlarni o'rganing. Dataset'ning tuzilishi va o'zgaruvchilarini chuqurroq tushunish uchun bar graph va scatter plot kabi oddiy data visualization texnikalaridan hamda asosiy statistik usullardan foydalaning.
4. Model quring va baholang
Qulay machine learning yoki statistik vositalar yordamida oddiy predictive model ishlab chiqing. Model 1-qadamda belgilangan maqsadlarga javob berishiga ishonch hosil qilish uchun uning samaradorligini test qiling. Yangi boshlovchilar uchun Python kutubxonalari yoki Excel kabi foydalanuvchiga qulay interfeysli vositalar juda samarali bo'lishi mumkin.
5. Natijalarni ulashing va deploy qiling
Topilmalaringizni stakeholder'larga aniq va amaliy formatda taqdim eting. Agar mos bo'lsa, modelning ta'sirini kuzatish va keyingi takomillashtirish uchun feedback to'plash maqsadida uni kichik ko'lamdagi production muhitiga deploy qiling.
Kichik loyihalar uchun maslahatlar: Shaxsiy xarajatlarni tahlil qilish yoki oddiy natijalarni bashorat qilish kabi o'zingizga tanish muammodan boshlang. Mukammal natijalarga erishishdan ko'ra jarayonni o'rganishga e'tibor qarating. Tajriba qilish va o'zingizga ishonchni oshirish uchun open-source vositalar va resurslardan foydalaning.
Agar bu sizning birinchi data science loyihangiz bo'lsa, ushbu freymvorkdan foydalaning, natijalaringizni baholang va eng muhimi, tajribangiz haqida mulohaza yuriting.
Shu xulosalarni keyingi loyihangizga olib o'ting va o'sha loyiha uchun yuqorida aytib o'tilgan oldindan belgilangan standart lifecycle'lardan birini qo'llash haqiqatan ham foydali bo'lish-bo'lmasligini hal qiling.
Xulosa
Data science lifecycle — zamonaviy data science'ning tamal toshi. Uning bosqichlari va tamoyillarini tushunish orqali mutaxassislar data science loyihalarining murakkabliklarida ishonch bilan yo'l topa oladi.
Nima bilan shug'ullanayotganingizdan qat'i nazar — unstructured data bilan ishlaysizmi, modellar yaratasizmi yoki machine learning algoritmlarini deploy qilasizmi — lifecycle muvaffaqiyat sari yo'l xaritasini taqdim etadi.
Data science ekspertlari va jamoalari o'z yondashuvlarini o'rganish va takomillashtirishda davom etar ekan, lifecycle freymvorki har qanday operatsiyalarda yuksak natijalarga erishish uchun asosiy vosita bo'lib qolmoqda.
Va nihoyat, agar data science sohasidagi karyerangizni rivojlantirishga qiziqsangiz, ixtiyoringizda bizning data scientist va data analyst roadmap'larimiz borligini unutmang. Bu roadmap'lar o'rganish vaqtingizni haqiqatan ham muhim va dolzarb mavzularga qaratishga yordam beradi.
- Data Science va Cyber Security: Qaysi biri sizga mos?
- Data Science va Software Engineering: Qaysi birini tanlash kerak?
- Data Science va AI: Men o'z yo'limni qanday tanlagan bo'lardim
- Data Science va Business Analytics: Men o'z yo'limni qanday tanlagan bo'lardim
- Data Science va Data Engineering: Mening tajribamdan saboqlar
- Data Science va statistika: Ular qanday farqlanadi?
- Data Science va Computer Science: Qaysi yo'lni tanlash kerak
- Data Science va Data Analytics: Qaysi biri sizga to'g'ri keladi?
- Data Science va Machine Learning: Ular qanday farq qiladi?
- Data Science yaxshi karyerami? Mutaxassisdan maslahatlar