Eng muhim 60+ Data Science intervyu savollari va javoblari
Ushbu savollar yordamida Data Science bo'yicha bilimingizni sinang, baholang va oshiring.
Correlation va causation o'rtasida qanday farq bor?

Data science intervyulari o'ziga xos alohida toifadir. Sizdan bir vaqtning o'zida statistika, dasturlash va biznes tafakkurini uyg'unlashtira olish kutiladi. Hatto tajribali mutaxassislar ham bunga maxsus tayyorgarlik ko'rishlari kerak, chunki bu intervyular soha bilimidan ko'proq narsani baholaydi. Ular qanday fikrlashingiz, muammolarni qanday hal qilishingiz, trendlardan qanchalik xabardor ekaningiz va natijalaringizni o'sha zahoti qanday tushuntira olishingizni tekshiradi.
Ushbu qo'llanma keng qamrovli bo'lib, unda 60 dan ortiq keng tarqalgan data science intervyu savollari va javoblari hamda tajribali nomzodlarni ham qoqiltiradigan ba'zi keng tarqalgan xatolar jamlangan. Savollar uchta asosiy yo'nalishga ajratilgan: nazariy bilimlar (statistika, machine learning, data wrangling), kodlash ko'nikmalari (Python va SQL) va biznes kommunikatsiyasi (jarayonni tushuntirish va yechimni biznes maqsadlariga moslashtirish).
Samaraliroq mashq qilishingiz uchun faol eslash va o'zingizni sinab ko'rishga mo'ljallangan flashcard'larni ham qo'shdim. Chuqurroq o'rganmoqchimisiz? Javoblaringiz tayanadigan asoslarni mustahkamlash uchun data science roadmap'iga nazar soling. Keling, data science'ning asosiy tushunchalaridan boshlaymiz.
Data Science intervyusiga tayyorgarlik
Quyidagi maslahatlarni yodda tutsangiz, data science intervyusidan muvaffaqiyatli o'tasiz:
- Statistika, ehtimollik va machine learning bo'yicha poydevoringizni mustahkamlang. p-value'lar, bias-variance tradeoff va classification metric'lari kabi tushunchalarni aniq tushunib oling.
- Python, R (ixtiyoriy) va SQL'da kod yozishni mashq qiling, ayniqsa data wrangling, join'lar, aggregation'lar va real hayotdagi feature engineering kabi vazifalarni.
- Modellarni real ma'lumotlarga qo'llay olishingizni ko'rsatadigan amaliy loyihalar yarating. Kaggle, HackerRank va GitHub kabi platformalar ularni namoyish etish uchun ajoyib joy.
- Fikrlash jarayoningizni tushuntirishni o'rganing. Jarayoningiz va trade-off'larni faqat texnik tilda emas, biznes tilida ham tushuntirishni mashq qiling.
- Sizga beriladigan savollar turlari bilan tanishish uchun ushbu qo'llanmani o'rganing. Javoblaringiz tushunarliroq va esda qolarliroq bo'lishi uchun o'z misollaringizdan foydalaning.
- Kompaniyani va u ma'lumotlardan qanday foydalanishini tushuning. Ularning mahsuloti, data stack'i yoki sohadagi muammolarini bilish javoblaringizni moslashtirishga va puxta o'ylangan savollar berishga yordam beradi.
Barcha savollar va javoblar
Asosiy tushunchalar
Correlation va causation o'rtasida qanday farq bor?
Correlation — ikki o'zgaruvchi o'rtasidagi bog'liqlikni ko'rsatadigan statistik o'lchov. Ulardan biri o'zgarganda ikkinchisi ham ijobiy yoki salbiy yo'nalishda o'zgaradi. Biroq bu bir o'zgaruvchi ikkinchisining o'zgarishiga sabab bo'ladi degani emas. Causation esa bir o'zgaruvchi ikkinchisida bevosita o'zgarishni keltirib chiqarishini anglatadi. U shunchaki aloqadorlikni emas, balki sabab-oqibat munosabatini nazarda tutadi. Causation'ni isbotlash uchun chuqurroq tahlil va qo'shimcha dalillar kerak bo'ladi.
Misol: Xarid ilovasida savatni tashlab ketish va ilovani o'chirib tashlash ko'rsatkichlari o'rtasida correlation bor. Savatini tashlab ketgan foydalanuvchilar ko'pincha oradan ko'p o'tmay ilovani o'chirib yuborishadi. Lekin bu savatni tashlab ketish kimnidir ilovani o'chirishga majbur qiladi degani emas. Haqiqiy sabab haddan tashqari ko'p bosqichli, asabga tegadigan xarid jarayoni bo'lishi mumkin. Aynan shu murakkablik ikkala xatti-harakatga ham olib keladi: savatni tashlab ketishga ham, ilovani o'chirishga ham. Demak, correlation mavjud bo'lsa-da, chuqurroq o'rganmasdan turib buni causation deb bo'lmaydi.

Data science'da statistikaning o'rni qanday?
Data science'da statistikaning o'rni data scientist'larga ma'lumotlarni tushunish va umumlashtirish, pattern'larni aniqlash, modellarni validatsiya qilish, noaniqlik bilan ishlash (masalan, yo'q yoki shovqinli ma'lumotlar) hamda dalillarga asoslangan qarorlar qabul qilishda yordam berishdan iborat.
Masalan:
- Mean va median markaziy tendensiyani umumlashtiradi.
- Standard deviation va variance o'zgaruvchanlikni o'lchaydi.
- Hypothesis testing farazlarni tasdiqlaydi.
- Regression analysis o'zgaruvchilar o'rtasidagi bog'liqliklarni bashorat qiladi.
- Bayesian inference yangi ma'lumotlar kelib tushgan sari taxminlarni yangilab boradi.
Use case: marketing jamoasi ikki email kampaniyasini solishtirish uchun A/B test o'tkazadi. Statistik usullar click-through rate'lardagi farq haqiqiymi yoki shunchaki tasodifmi, shuni aniqlashga yordam beradi.
Missing data bilan qanday ishlaysiz?
Dataset'imda missing value'lar borligini sezganimdan so'ng, avval ular qanday ko'rinishda uchrashini aniqlayman. Ular NaN, None, bo'sh satrlar, -999 kabi g'alati belgilar, ikki yoki undan ortig'ining kombinatsiyasi yoki boshqa biror narsa sifatida ifodalanganmi?

Missing data'm qanday ko'rinishga ega ekanini tushunib olgach, bu qiymatlar nima uchun yo'qligini chuqurroq o'rganaman. Ular odatda uch toifaga bo'linadi:
-
Missing Completely At Random (MCAR): hech qanday pattern yo'q, shunchaki tasodifiy bo'shliqlar. Bularni odatda xavfsiz olib tashlash mumkin, ayniqsa ular ko'p bo'lmasa.
Misol: so'rovnoma dataset'ida javoblarning tasodifiy qismiga ta'sir qilgan texnik nosozlik tufayli daromad yozuvlarining 10% yo'q. Bunda yosh, ta'lim, bandlik holati yoki boshqa biror narsaga asoslangan pattern yo'q.
-
Missing At Random (MAR): bu holatda missing data daromad qiymatining o'ziga emas, balki boshqa kuzatilgan o'zgaruvchilarga bog'liq bo'ladi.
Misol: o'sha dataset'da
incomeqiymatlarining 10% yo'q va ular asosan talaba bo'lgan respondentlarga to'g'ri keladi. Bu yerda missing data haqiqiy daromad qiymatiga emas,occupationo'zgaruvchisiga bog'liq.occupation,education levelyokiagekabi bog'liq feature'lar asosida impute qiling.occupation,education levelyokiagekabi bog'liq feature'lar asosida impute qiling. Missing data bias keltirib chiqarmagani uchun ularni olib tashlash yoki mean/median bilan impute qilish xavfsiz. -
MNAR (Missing Not At Random): qiymat yo'qligining sababi aynan o'sha qiymatning o'ziga bog'liq.
Misol: agar ko'p pul sarflaydiganlar daromadini oshkor qilmaslikni tanlasa, bu holat bilan ishlash qiyinroq va ba'zan uni missingness flag yordamida kuzatib borish yaxshiroq. Daromad miqdori oshgani sari qiymat yo'q bo'lish ehtimoli ham ortadi. Bu yerda imputation xavfli. Men missingness'ni binary indikator (
income_missing) bilan belgilashni yoki EM algoritmlari yoki data augmentation usullari kabi MNAR'ni hisobga ola oladigan modellardan foydalanishni ko'rib chiqaman.
Missingness turini aniqlaganimdan so'ng, quyidagilardan birini tanlayman: a. Deletion (agar xavfsiz bo'lsa):
- Listwise: missing value'lari bor satrlarni olib tashlash (faqat missingness tasodifiy va kam bo'lganda).
- Pairwise: correlation kabi hisob-kitoblar uchun mavjud qiymatlardan foydalanish.
- Ustunlarni olib tashlash: missing data'si ko'p bo'lgan, foydasi kam feature'larni olib tashlash.
b. Oddiy imputation:
- Mean/Median/Mode: distribution'ga qarab sonli yoki categorical ustunlar uchun ishlatiladi.
- Ixtiyoriy qiymatlar: agar kontekstga mos bo'lsa, 0 yoki "Unknown" bilan to'ldirish.
- Forward/Backward fill: vaqt bo'yicha izchillikni saqlash uchun time series'larda eng yaxshi usul.
c. Murakkab imputation:
- KNN imputer: distance metric'lar yordamida o'xshash satrlarni topib, bo'shliqlarni to'ldiradi.
- Iterative imputer: missing value'larni taxmin qilish uchun boshqa ustunlar asosida model quradi.
- Interpolation: sonli ketma-ketliklar uchun yaxshi, ayniqsa ma'lumotlar biror trendga bo'ysunganda.
d. Missingness'ni feature sifatida ishlatish:
- Agar yo'q qiymatning o'zi qandaydir signal tashishi mumkin bo'lsa, binary indikator ustunini qo'shaman (masalan, was_missing = 1).
e. Oversampling yoki undersampling:
- Agar missing data class imbalance'ga sabab bo'lsa, target distribution'ni adolatli saqlash uchun resampling'dan foydalanaman.
Keng tarqalgan xato: Missingness pattern'ini tushunmasdan qiymatlarni to'ldirish. Masalan, MNAR ma'lumotlarida mean imputation'dan foydalanish bias keltirib chiqarishi va modelingizning bashorat qilish kuchini zaiflashtirishi mumkin.
Univariate, bivariate va multivariate tahlil o'rtasida qanday farq bor?
Univariate analysis — bitta o'zgaruvchini alohida, hech qanday solishtirishlarsiz ko'rib chiqish: faqat uning distribution'i, central tendency'si yoki tarqoqligini tushunish. Masalan, men histogram'lar yoki summary statistics yordamida sinfdagi o'rtacha test balini yoki turli baho oraliqlarining chastotasini ko'rib chiqishim mumkin.
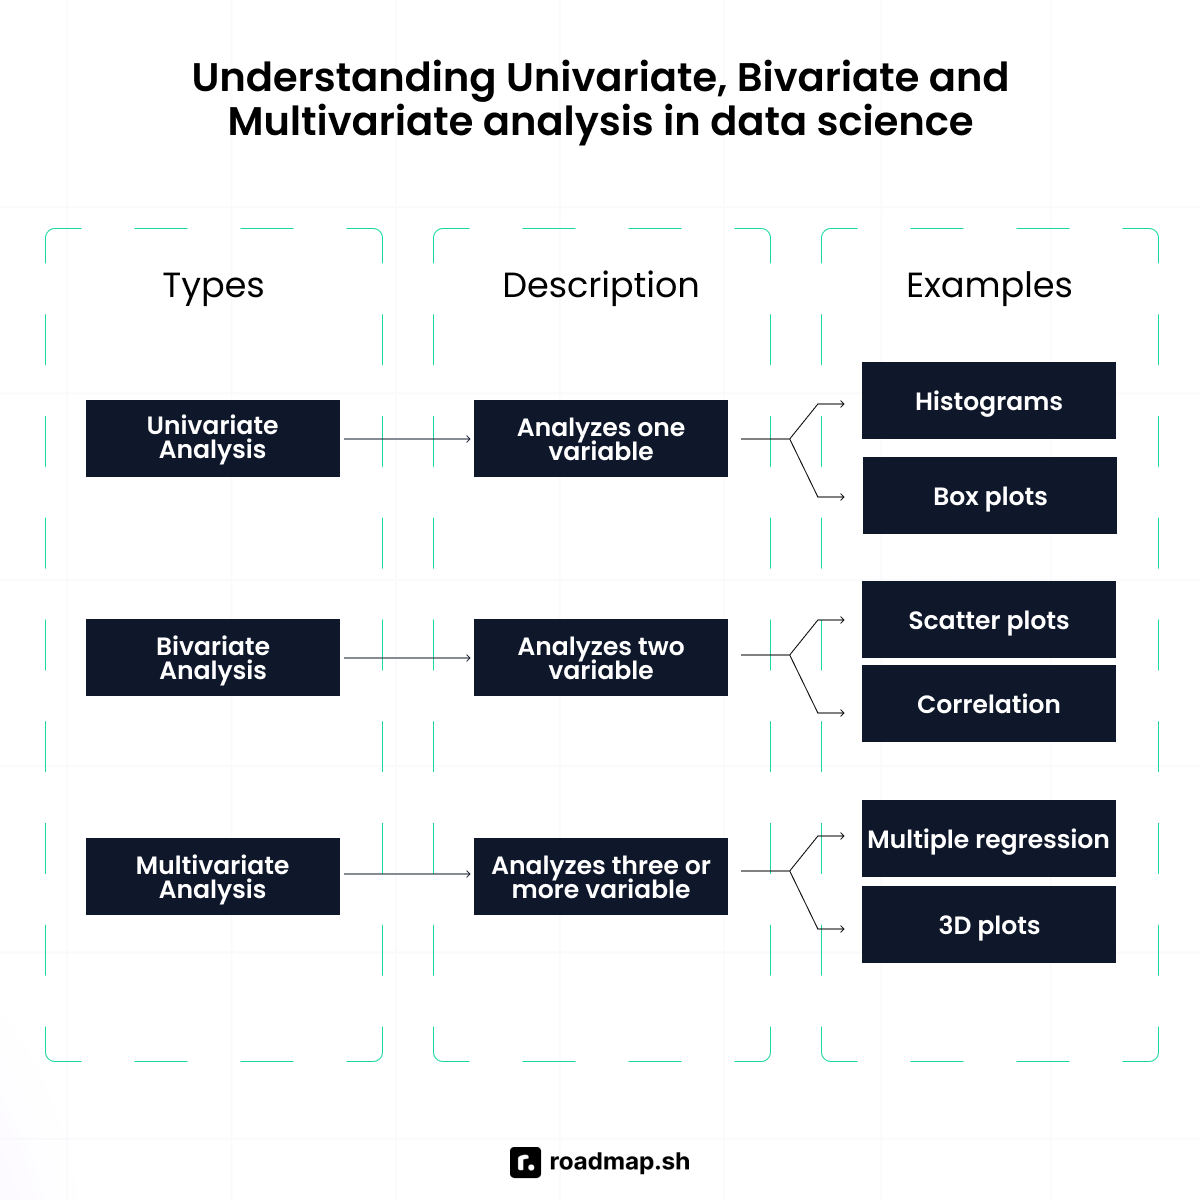
Bivariate analysis ikki o'zgaruvchi o'rtasidagi bog'liqlikni, masalan, talabalarning o'qishga sarflagan vaqti ularning test ballariga qanday ta'sir qilishini o'rganadi. Buni tahlil qilish uchun men trendlar yoki pattern'larni aniqlashda correlation, scatter plot'lar yoki chiziqli grafiklar kabi vositalardan foydalanardim.
Multivariate analysis esa bir vaqtning o'zida uch yoki undan ortiq o'zgaruvchi bilan ishlaydi. U bir nechta omil birgalikda natijaga qanday ta'sir qilishini tushunishga qaratilgan. Masalan, men uyqu soatlari, o'qishga sarflangan vaqt va kofein iste'moli birgalikda test ballariga qanday ta'sir qilishini o'rganishim mumkin. Bunday holda birgalikdagi ta'sirni tahlil qilish uchun regression yoki tree-based modeldan foydalanardim.
Long format va wide format ma'lumotlar o'rtasida qanday farq bor?
Long format va wide format ma'lumotlar o'rtasidagi farq ma'lumotlaringiz qanday tuzilganiga borib taqaladi. Wide format'da ustunlardagi qiymatlar takrorlanmaydi, long format'da esa ustunlardagi qiymatlar takrorlanadi.
Wide format'da ma'lumotlar ustunlar bo'ylab yoyiladi. Har bir o'zgaruvchi (Jan, Feb, March) o'z ustuniga ega bo'ladi. Buni odatda hisobotlar yoki dashboard'larda ko'rasiz.

Long format'da ma'lumotlar satrlar bo'ylab ustma-ust joylashtiriladi. Bitta ustunda qiymatlar saqlanadi, boshqa ustun esa bu qiymatlar nimani ifodalashini ko'rsatadi. Bu format guruhlangan xulosalar va time series tahlili uchun qulayroq.

Use case: wide format hisobot tayyorlash va data visualization'lar yaratish uchun foydali. Long format esa time series, guruhlangan xulosalar hamda Seaborn yoki ggplot kabi grafik chizish vositalari uchun afzal ko'riladi.
Keng tarqalgan xato: wide format'dagi ma'lumotlarni avval qayta shakllantirmasdan turib, ular ustida guruh darajasidagi tahlil qilishga urinish.
Multicollinearity nima va uni qanday aniqlaysiz?
Multicollinearity — regression modelidagi ikki yoki undan ortiq independent variable o'zaro kuchli correlation'ga ega bo'lgan, ya'ni deyarli bir xil ma'lumot beradigan holat. Bu model target'ga aslida qaysi o'zgaruvchi ta'sir qilayotganini aniqlashini qiyinlashtiradi va koeffitsiyentlarning ishonchsiz yoki beqaror baholanishiga olib keladi.
Masalan, iqtisodiy o'sishni o'rganadigan regression modelida odatda GDP, Unemployment Rate va Consumer Spending o'zgaruvchilari ishlatiladi. Bu o'zgaruvchilarning barchasi o'zaro bog'liq, shuning uchun model kutilgandek samarali bo'lmasligi mumkin.
Multicollinearity'ni aniqlash uchun quyidagilardan foydalaning:
- Correlation matrix: correlation matrix o'zgaruvchilar o'rtasidagi bog'liqlik kuchini vizual ko'rsatish orqali multicollinearity'ni aniqlaydi. Umumiy qoidaga ko'ra, 0.6 dan yuqori har qanday correlation qiymati kuchli multicollinearity'dan dalolat beradi.
- Variance inflation factor (VIF): VIF regression koeffitsiyentining variance'i multicollinearity tufayli qanchalik oshib ketganini ko'rsatadigan sonli qiymat berish orqali multicollinearity'ni aniqlaydi. 5 dan katta VIF qiymati o'rtacha multicollinearity'ni, 10 dan yuqori qiymatlar esa kuchli multicollinearity'ni bildiradi.
- Condition index: condition index — multicollinearity'ni aniqlash vositasi. 10 dan yuqori qiymatlar o'rtacha multicollinearity'ni, 30 dan yuqori qiymatlar esa kuchli multicollinearity'ni ko'rsatadi. Condition index independent variable'lar bir-biri bilan qanchalik bog'liqligini ularning eigenvalue'lari o'rtasidagi munosabatlarni tahlil qilish orqali tekshiradi.
Keng tarqalgan xato: VIF'ni tekshirmasdan o'zaro kuchli correlation'ga ega predictor'larni modelga kiritish model xatosini oshirib, uning barqarorligini pasaytirishi mumkin.
Data science'da variance nima?
Data science'da variance dataset'dagi sonlarning qanchalik tarqoqligini o'lchaydi. Oddiy qilib aytganda, u to'plamdagi har bir son mean'dan (o'rtacha qiymatdan) qanchalik uzoqda ekanini o'lchaydi. Bu dataset'dagi qiymatlar qanchalik tarqoq yoki bir xil ekanini tushunishga yordam beradi.
Past variance misoli: Mean: (78 + 79 + 80 + 81 + 82) / 5 = 80
Imbalanced data deganda nimani tushunasiz?
Imbalanced data — dataset'dagi class'lar, label'lar yoki kategoriyalar teng miqdorda ifodalanmagan holat. Imbalanced dataset'larda bir kategoriyaga tegishli sample'lar boshqalariga qaraganda sezilarli darajada ko'p yoki kam bo'ladi. Imbalanced data supervised machine learning va deep learning'da keng tarqalgan muammo bo'lib, unda sample'lar turli class'lar o'rtasida notekis taqsimlangan bo'ladi. Bu modellarda, masalan, sog'liqni saqlash xizmatlarida ishlatiladigan modellarda, bir tomonlama natijalarga olib kelishi va ularning ishonchliligi hamda samaradorligiga ta'sir qilishi mumkin.
Masalan, agar siz email spam'ni aniqlash modelini qursangiz va dataset'ingizda 5% spam va 95% spam bo'lmagan xatlar bo'lsa, ma'lumotlar spam bo'lmagan xatlar tomonga og'gan bo'ladi. Bunday nomutanosiblik modelning unumdorligiga, ayniqsa production'da, salbiy ta'sir qilishi mumkin, chunki model spam'ni samarali aniqlay olmagan holda shunchaki majority class'ni bashorat qilish orqali ham yuqori accuracy'ga erishishi mumkin.
Preprocessing jarayonida categorical va continuous variable'larga qanday turlicha yondashasiz?
Categorical variable — jins, yosh guruhi yoki ta'lim darajasi kabi sifatlar yoki label'larga asoslangan, qat'iy belgilangan variantlarga ega ustun. Ular ustida to'g'ridan-to'g'ri matematik amallar bajarib bo'lmaydi, shuning uchun preprocessing jarayonida men odatda bu kategoriyalarni model tushuna oladigan binary ustunlarga aylantirish uchun one-hot encoding'ni qo'llayman.

Continuous variable esa bo'y, harorat yoki tezlik kabi ma'lum bir oraliqdagi istalgan qiymatni qabul qilishi mumkin. Ular sonli bo'lgani uchun ular ustida hisob-kitoblar bajarish mumkin. Lekin ularni modelga berishdan oldin barcha feature'lar o'xshash oraliqda bo'lishi uchun normalization yoki standardization yordamida scale qilaman. Bu biror feature faqat qiymatlari kattaroq bo'lgani uchungina qolganlaridan ustun kelib qolishining oldini oladi.
Ma'lumotlarni wide format'dan long format'ga qanday o'tkazishingizni tushuntiring. Bu nima uchun kerak bo'lishi mumkin?
Ma'lumotlarni wide format'dan long format'ga o'tkazish uchun men odatda ustunlarni satrlarga unpivot qilishda pandas'dagi melt() funksiyasidan foydalanaman. Bu, ayniqsa, ustunlar bo'ylab takrorlanuvchi o'lchovlar — masalan, oylik savdo yoki so'rovnoma javoblari — bo'lganda va ma'lumotlarni tahlil yoki grafik chizish uchun tidy ko'rinishga keltirmoqchi bo'lganingizda foydali.
Masalan, agar menda har bir ustun bitta oyni ifodalaydigan DataFrame bo'lsa, identifikatorni (masalan, mahsulot nomini) o'z holicha qoldiraman, qolganlarini esa har bir satr bitta mahsulot–oy–savdo kombinatsiyasini ko'rsatadigan qilib melt qilaman. Bu ma'lumotlarni guruhlash, filter qilish yoki modellarga berishni osonlashtiradi.
Formatlari bir-biriga mos kelmaydigan bir nechta manbadagi ma'lumotlarni qanday birlashtirasiz?
Formatlari bir-biriga mos kelmaydigan turli manbalardagi ma'lumotlarni birlashtirganda, men birinchi navbatda hamma narsani standartlashtiraman: sanalar, ustun nomlari, boolean qiymatlar, sonlar va hokazo — ularning barchasi "bir tilda gaplashishi" uchun. Shundan so'ng men:
- Schema'larni moslashtiraman: dataset'lar bo'ylab ustunlarni bir-biriga moslayman. Agar birida ortiqcha ustunlar bo'lsa, ularning ahamiyatiga qarab olib tashlayman yoki qoldiraman.
- Kategoriyalarni yagona ko'rinishga keltiraman: keyingi bosqichlarda muammo chiqmasligi uchun "Y" va "Yes" kabi nomuvofiqliklarni tozalayman.
- Manbani belgilayman: har bir satr qayerdan kelganini bilish uchun manba ustunini qo'shaman. Bu keyinchalik kuzatish yoki debugging uchun juda foydali.
- Merge yoki stack qilaman: agar tuzilma bir xil bo'lsa, concat() ishlataman. Agar mijoz ID'si kabi biror narsa bo'yicha moslashtirayotgan bo'lsam, merge yoki join'dan foydalanaman.
- Yakuniy tozalash: merge'dan keyin dublikatlar, mos kelmaydigan type'lar yoki buzilgan qiymatlarni qidirib, ularni tuzataman.
Ma'lumotlar type'lari yoki kalitlarni tekshirmasdan turib merge qilishdan qochaman. Bu satrlarning yo'qolishi yoki dublikat bo'lib qolishiga olib boradigan eng tez yo'l.
Statistika va ehtimollik
Central Limit Theorem nima va u nima uchun muhim?
Central Limit Theorem (CLT, markaziy limit teoremasi) quyidagini ta'kidlaydi: istalgan dataset'dan yetarlicha random sample olsangiz, ma'lumotlar skewed yoki tartibsiz bo'lsa ham, o'sha sample'larning o'rtacha qiymatlari qo'ng'iroqsimon shaklni, ya'ni normal distribution'ni hosil qila boshlaydi. Bu faqat sample'lar tasodifiy, bir-biridan mustaqil va yetarlicha katta (odatda 30 yoki undan ko'p) bo'lgandagina o'rinli.
Bu nima uchun muhim? Chunki o'rtacha qiymatlar normal shaklga kelgach, normal distribution'ning barcha vositalaridan foydalanish mumkin bo'ladi. Dastlabki ma'lumotlar normal bo'lmagan taqdirda ham standard error'larni hisoblashingiz, confidence interval'lar qurishingiz, hypothesis test'larni o'tkazishingiz, baholashlar qilishingiz va z-score'lardan foydalanishingiz mumkin.
Type I va Type II error'lar o'rtasida qanday farq bor?
Type I va Type II error o'rtasidagi farq shundaki, Type I error to'g'ri bo'lgan null hypothesis'ni rad etadi (false positive), Type II error esa noto'g'ri bo'lgan null hypothesis'ni rad eta olmaydi (false negative).

Faraz qilaylik, siz yangi dorini sinovdan o'tkazyapsiz. Null hypothesis — dori ta'sir qilmaydi, va haqiqatda ham u ta'sir qilmaydi. Type I error testingiz dori ta'sir qiladi deb ko'rsatganda, aslida esa ta'sir qilmaganda yuz beradi; bu false positive. Type II error esa, aksincha, dori haqiqatda ta'sir qilsa-yu, testlaringiz ta'sir qilmaydi deb ko'rsatganda yuz beradi: bu false negative.
p-value nima? Uni qanday talqin qilasiz?
p-value — hypothesis test'da olgan natijangizning ahamiyatliligini aniqlaydigan statistik o'lchov. Kichik p-value (<0.05) null hypothesis noto'g'ri ekaniga kuchli dalil bo'lib, uni rad etish kerakligini bildiradi.

Agar p-value ehtimoli 0.05 dan katta bo'lsa, null hypothesis'ni rad etish uchun yetarli dalil yo'q. Masalan, tajriba o'tkazganingizda p-value 0.03 chiqsa, null hypothesis'ni rad etishingiz kerak.
Confidence interval'larni oddiy so'zlar bilan tushuntiring.
Confidence interval (ishonch oralig'i) — sample ma'lumotlari asosida population parametrining haqiqiy qiymatini o'z ichiga olishi ehtimoli yuqori bo'lgan qiymatlar oralig'i. Aytaylik, siz o'rta maktab o'qituvchilaridan iborat sample o'rtasida so'rovnoma o'tkazdingiz va ularning o'rtacha maoshi $75,000 ekanini aniqladingiz. Bu shunchaki sample bo'lgani uchun u barcha o'qituvchilarni aks ettiradi deb aniq ayta olmaysiz, lekin quyidagicha deyishimiz mumkin:
"Barcha o'qituvchilarning haqiqiy o'rtacha maoshi $72,000 bilan $78,000 oralig'ida ekaniga 95% ishonchimiz komil."
Confidence interval $72,000 va $78,000 oralig'ida. U bizning baholashimizdagi noaniqlikni hisobga olish uchun zaxira oraliq beradi.

Probability distribution nima? Keng qo'llaniladigan bir nechtasini ayting.
Probability distribution (ehtimollik taqsimoti) tasodifiy hodisa yoki tajribaning turli mumkin bo'lgan natijalari qanchalik ehtimolli ekanini ko'rsatadi. U turli natijalarning ro'y berish ehtimollarini tasvirlab beradi. Boshqacha aytganda, bu: "Mana, sodir bo'lishi mumkin bo'lgan hamma narsa va ularning har biri qanchalik tez-tez sodir bo'lishini kutaman" deyishning bir usuli.
Keng qo'llaniladigan probability distribution'lar — normal (bell curve), binomial, Poisson va uniform distribution'lar.
Keng tarqalgan xato: distribution'larning turli turlari turlicha tahlilni talab qiladi. Tahlil uchun noto'g'ri distribution turidan foydalanish noto'g'ri natijalarga olib kelishi mumkin. Yana bir keng tarqalgan muammo — normallikni test qilmasdan turib ma'lumotlar normal distribution'ga bo'ysunadi deb faraz qilish.
Qachon t-test'dan, qachon z-test'dan foydalanasiz?
t-test va z-test o'rtasidagi farq ma'lumotlaringiz haqida nimalarni bilishingizga — sample hajmi va population standard deviation'iga borib taqaladi.

t-test'dan quyidagi hollarda foydalaning:
- Sample hajmi kichik (odatda n ≤ 30).
- Population standard deviation'i noma'lum.
- Shunga qaramay o'rtacha qiymatlarni solishtirmoqchisiz (sample bilan population'ni yoki ikki sample'ni o'zaro).
z-test'dan quyidagi hollarda foydalaning:
- Population standard deviation'ini bilasiz.
- Sample hajmingiz katta (odatda n > 30).
- Ma'lumotlar taxminan normal taqsimlangan.
Null hypothesis nima va uni rad etish kerakligini qanday aniqlaysiz?
Null hypothesis (H₀) — har qanday statistik tahlilning boshlang'ich nuqtasi va standart farazi. Uning g'oyasi shundan iboratki, ma'lumotlaringiz uni rad etish uchun kuchli dalil bermaguncha, ularda hech narsa sodir bo'lmayapti deb hisoblanadi: hech qanday hodisa, hech qanday ta'sir, siz test qilayotgan o'zgaruvchilar o'rtasida hech qanday bog'liqlik yo'q.

Null hypothesis'ni rad etish kerakmi-yo'qmi, bilish uchun men quyidagilarni qilaman:
Avval significance level'ni belgilayman, odatda 0.05. So'ng p-value'ni hisoblayman. Agar p-value 0.05 dan kichik yoki unga teng bo'lsa, null hypothesis'ni rad etaman, chunki natija statistik jihatdan ahamiyatli. Agar u 0.05 dan katta bo'lsa, uni rad etmayman, chunki yetarli dalil yo'q.
Random variable'lar bir xil taqsimlangan deb faraz qilinmasa, lekin ular baribir mustaqil va chekli ikkinchi momentlarga ega bo'lsa, Central Limit Theorem'ni tushuntiring.
Bu chalg'ituvchi savol, chunki intervyu oluvchi aslida klassik CLT haqida so'ramayapti. U sizning Lindeberg-Feller CLT bo'yicha bilimingizni tekshiryapti.
Klassik CLT'da barcha o'zgaruvchilar mustaqil va bitta probability distribution'dan olingan bo'ladi (ya'ni bir xil taqsimlangan). Lekin bu yerda intervyu oluvchi shuni so'rayapti: agar ular baribir mustaqil bo'lsa-yu, lekin bir xil taqsimlanmagan bo'lsa-chi? Bunday vaziyatlarda Lindeberg-Feller teoremasi yordam beradi.
Unga ko'ra, o'zgaruvchilar mustaqil bo'lsa, chekli ikkinchi momentlarga ega bo'lsa (ya'ni ularning variance'lari juda katta bo'lmasa) va hech bir o'zgaruvchi ustunlik qilmasa (Lindeberg sharti), bu o'zgaruvchilarning normallashtirilgan yig'indisi baribir normal distribution'ga yaqinlashadi. Demak, distribution'lar har xil bo'lsa ham, bu shartlar bajarilsa, o'rtacha qiymat baribir qo'ng'iroqsimon egri chiziqni hosil qiladi.
Long-tail distribution'ni tushuntiring va long tail'ga ega bo'lgan hodisalarga uchta misol keltiring. Ular classification va regression masalalarida nima uchun muhim?
Long-tail distribution — distribution'ning shunday turiki, unda ma'lumotlarning katta qismi o'rta atrofida to'planadi, lekin baribir chetlarga (tail'ga) uzoq cho'zilib ketadigan va katta ta'sirga ega bo'lgan ko'plab kam uchraydigan yoki g'ayrioddiy qiymatlar mavjud bo'ladi.
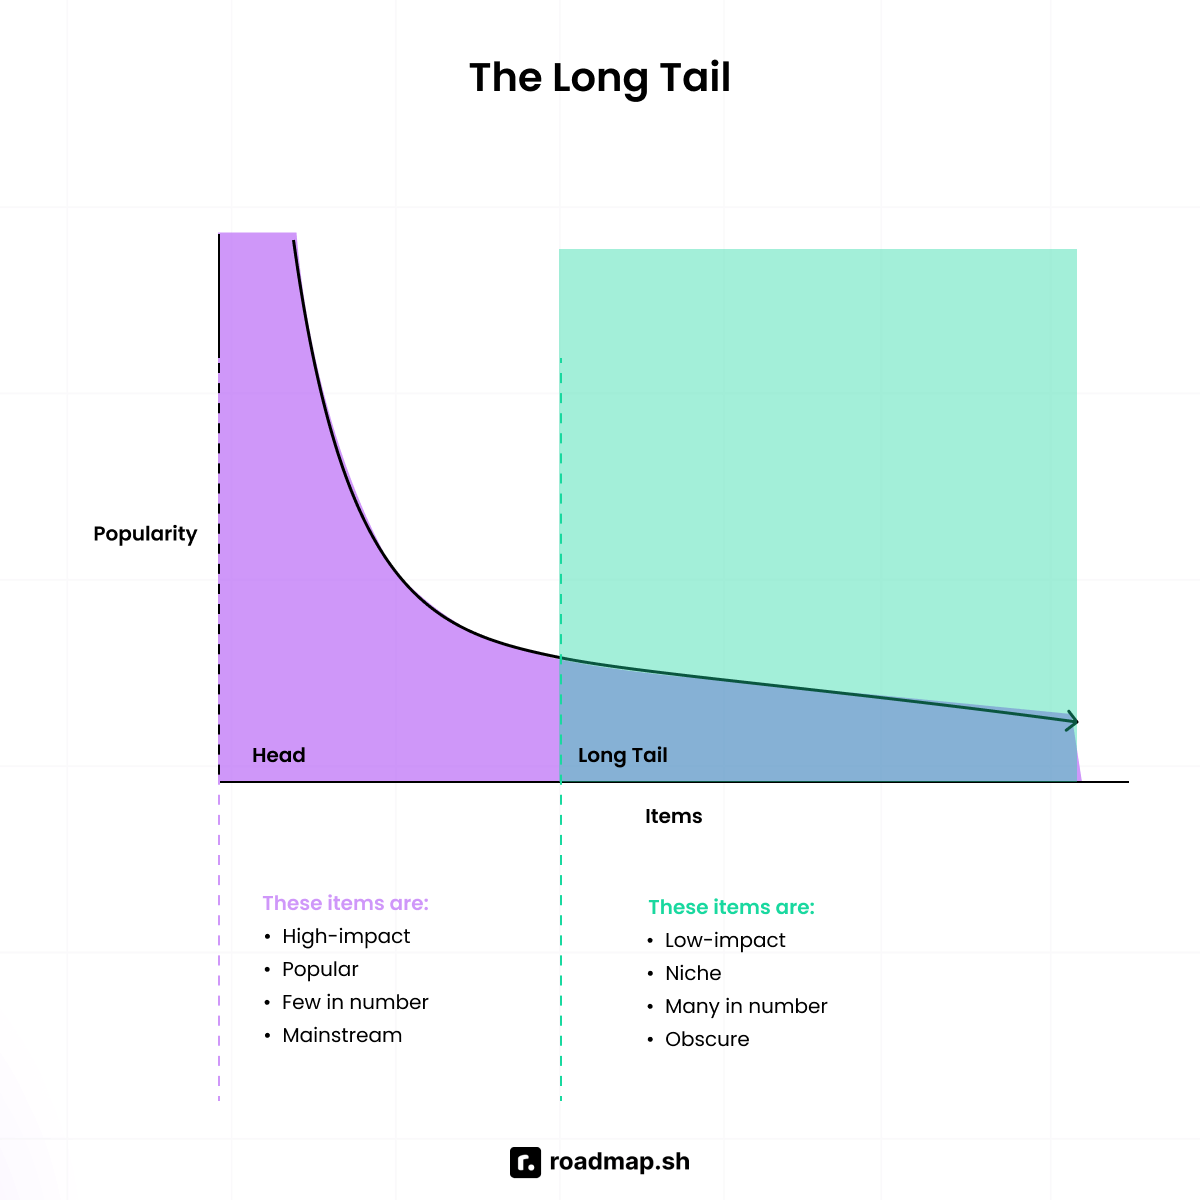
Ba'zi misollar:
-
SEO'dagi long-tail keyword'lar: bir nechta yuqori hajmli keyword'lar ("shoes" kabi) juda katta qidiruv hajmini oladi, ammo aniq va tor yo'nalishdagi qidiruvlardan ("waterproof hiking shoes for wide feet" kabi) iborat uzun tail ham mavjud bo'lib, ular birgalikda qidiruv traffic'ining katta qismini tashkil etadi. Bu long-tail keyword'lar tez-tez qidirilmaydi, lekin ular yaxshi konversiya beradi.
-
Kitob savdosi: Harry Potter kabi bestseller'lar bozorda ustunlik qiladi, lekin juda ko'p tor yo'nalishdagi kitoblar (hatto Jane Austen kabi klassikalar ham) orqa fonda barqaror sotilib turadi. Bu kamroq mashhur kitoblarning umumiy savdosi ko'pincha bestseller'larnikidan oshib ketadi.
-
Hashamatli sumkalar: bir nechta brendlar doim trendda bo'ladi. Biroq hali ham sotilib turadigan va bozor uchun ahamiyatli bo'lgan noyob, kamroq tanilgan brendlarning uzun ro'yxati ham mavjud.
Ular classification va regression masalalarida nima uchun muhim:
Long-tail distribution'lar model unumdorligini buzib yuborishi mumkin, chunki ko'pchilik modellar majority class'da, ya'ni "head"da train qilinadi va tail'dagi kam uchraydigan, ammo muhim hodisalarni e'tiborsiz qoldiradi. Bu fraud detection yoki churn modeling kabi kam uchraydigan hodisalar eng muhim bo'lgan holatlarda xavfli. Ular Mean Squared Error'ga ham ta'sir qiladi: u bashorat qilingan va haqiqiy qiymatlar orasidagi farqni kvadratga oshiradi, shuning uchun modelingiz umuman olganda yaxshi ishlasa ham, tail'dagi holatlardan kelib chiqqan bir nechta ekstremal xato score'ni keskin oshirib yuborishi mumkin.
Long-tail distribution'lar majority tomonga biased bo'lgan modellarni yuzaga keltirishi, xatolarni buzib ko'rsatishi va muhim bo'lgan kam uchraydigan hodisalarni o'tkazib yuborishingizga sabab bo'lishi mumkin. Ular bilan ishlash uchun yaxshiroq sampling usullari va bunday kam uchraydigan, ammo ahamiyatli hodisalarni to'g'ri hisobga oladigan loss function'lardan foydalanish talab etiladi.
Machine learning va algoritmlar
Supervised, unsupervised va reinforcement learning o'rtasida qanday farq bor?
Supervised, unsupervised va reinforcement learning o'rtasidagi farq model qanday o'rganishida. Quyidagi jadvalda ularning farqlari va har birining keng tarqalgan use case'lari tavsiflangan.
| Learning turi | Tavsif | Keng tarqalgan use case'lar |
|---|---|---|
| Supervised Learning | Modellar labeled data'da train qilinadi, bunda har bir misol input va ma'lum output'ni o'z ichiga oladi. Model yangi, ko'rilmagan input'lar uchun output'ni bashorat qilishni o'rganadi. | Regression va classification vazifalari. |
| Unsupervised Learning | Modellar unlabeled data'da train qilinadi. Maqsad — aniq output label'larisiz ma'lumotlardagi yashirin pattern'lar yoki tuzilmani topish. | Clustering, dimensionality va reduction vazifalari. |
| Reinforcement Learning | Model o'z harakatlariga qarab mukofot yoki jazo olib, sinov va xato orqali o'rganadi. U vaqt davomida mukofotni maksimal qilish uchun ketma-ket qarorlar qabul qilishga intiladi. | O'yinlar, robototexnika va AI asosidagi qaror qabul qilish tizimlari. |
Bias-variance tradeoff'ni tushuntiring.
Bias-variance tradeoff — modelning pattern'larni o'rganish qobiliyati (past bias) bilan yangi ma'lumotlarga generalize qilish qobiliyati (past variance) o'rtasidagi muvozanat. Bias — model ma'lumotlar haqida kuchli farazlar qilganda yuzaga keladigan xato: yuqori bias underfitting'ga olib kelishi mumkin. Variance — modelning ma'lumotlardagi kichik tebranishlarga sezgirligi; yuqori variance overfitting'ga olib kelishi mumkin.

Cross-validation nima va u nima uchun muhim?
Cross-validation — modelning unumdorligini muayyan dataset'da baholash usuli. U dataset'ni qism to'plamlarga, odatda training, test va validation set'larga ajratadi. Model ko'rilmagan ma'lumotlarda ham yaxshi generalize qilishiga ishonch hosil qilish va overfitting'ni to'xtatish uchun bu jarayon bir necha marta takrorlanadi.

Overfitting nima va uning oldini qanday olish mumkin?
Machine learning'da overfitting model training data'ni, jumladan ahamiyatsiz detallarni ham haddan tashqari yaxshi o'rganib olganda yuz beradi. Natijada model training data'da juda yaxshi, boshqa ma'lumotlarda esa yomon ishlaydi.
Oldini olish usullari:
- Regularization (L1/L2): bu usul model haddan tashqari murakkablashib ketmasligi uchun katta weight'larga penalty qo'shadi.
- Cross-validation: model yaxshi generalize qilishiga ishonch hosil qilish uchun uni ma'lumotlarning turli bo'laklarida test qilishga yordam beradi.
- Pruning (tree modellar uchun): modelni ortiqcha murakkablashtiradigan keraksiz shoxlarni kesib tashlaydi.
- Early stopping: validation set'dagi unumdorlik yaxshilanishdan to'xtaganda training'ni to'xtatadi.
- Dropout (neural network'lar uchun): bu usul training vaqtida neyronlarni tasodifiy ravishda o'chirib qo'yadi, shunda tarmoq muayyan yo'llarga haddan tashqari bog'lanib qolmaydi.
Decision tree'lar qanday ishlaydi?
Decision tree (qaror daraxti) — classification va regression vazifalari uchun ishlatiladigan machine learning algoritmi. U daraxtsimon tuzilma bo'ylab qaror qabul qiladi: undagi internal node'lar atributlar bo'yicha tekshiruvlarni, shoxlar atribut qiymatlarini, leaf node'lar esa bashoratlarni ifodalaydi.

Decision tree'lar ko'p qirrali bo'lib, ko'plab machine learning vazifalarida qo'llaniladi.
Misol: kredit berish bo'yicha decision tree
- 1-qadam – savol berish (Root Node): arizachining kredit reytingi > 700 mi?
- Ha bo'lsa, Internal Node'ga o'tiladi.
- Yo'q bo'lsa, Leaf Node'ga o'tiladi (kredit tasdiqlanmaydi).
- 2-qadam – qo'shimcha savollar (Internal Nodes): arizachining daromadi > $50,000 mi?
- Ha bo'lsa, kredit tasdiqlanadi (Leaf Node).
- Yo'q bo'lsa, Leaf Node'ga o'tiladi (kredit tasdiqlanmaydi).
- 3-qadam - qaror (Leaf Node)
- Leaf Node 1: kredit tasdiqlanmaydi (agar kredit reytingi ≤ 700 bo'lsa).
- Leaf Node 2: kredit tasdiqlanadi (agar kredit reytingi > 700 va daromad > $50,000 bo'lsa).
- Leaf Node 3: kredit tasdiqlanmaydi (agar kredit reytingi > 700 va daromad ≤ $50,000 bo'lsa).
Keng tarqalgan xato: agar daraxtning juda chuqurlashib ketishiga va haddan tashqari ko'p shox chiqarishiga yo'l qo'ysangiz, u ma'lumotlarga overfit bo'lib qolishga moyil bo'ladi.
Random forest decision tree'dan nimasi bilan farq qiladi?
Ushbu jadvalda decision tree'lar va random forest'lar o'rtasidagi farq hamda ularni accuracy, training vaqti va boshqa xususiyatlarga qarab qachon ishlatish kerakligi tavsiflangan.

Random forest bir nechta decision tree'lar to'plamidir, decision tree esa bir qator qarorlar asosida natijalarni bashorat qiladigan yagona model. Random forest'da har bir daraxt ma'lumotlarning qism to'plami va feature'larning qism to'plamida train qilinadi va ularning ikkalasi ham tasodifiy tanlanadi. Decision tree — qarorlarni va ulardan kelib chiqadigan mumkin bo'lgan natijalarni ifodalash uchun ishlatiladigan oddiy, daraxtsimon tuzilma. Random forest'dagi ko'plab daraxtlar bootstrap qilingan sample'lar va tasodifiy feature selection'dan foydalanadi, so'ng accuracy'ni oshirish va overfitting'ni kamaytirish uchun bashoratlarni o'rtachalaydi.
Logistic regression qanday ishlaydi?
Logistic regression — biror natija, hodisa yoki kuzatuvning ehtimolini bashorat qilish orqali odatda binary classification vazifalarida ishlatiladigan supervised machine learning algoritmi. Model faqat ikkita mumkin bo'lgan natija bilan cheklangan binary natija beradi: ha/yo'q, 0/1 yoki true/false. Logical regression bir yoki bir nechta independent variable o'rtasidagi bog'liqlikni tahlil qiladi va ma'lumotlarni diskret class'larga ajratadi. So'ngra bu bog'liqlik logistic (sigmoid) funksiya yordamida o'sha omillardan birining qiymatini, ya'ni binary natija ehtimolini bashorat qilish uchun ishlatiladi. U asosan predictive modeling uchun qo'llaniladi.
Masalan, 0 negative class'ni, 1 esa positive class'ni ifodalaydi. Logistic regression odatda natija o'zgaruvchisi ikki kategoriyadan (0 yoki 1) birini ko'rsatadigan binary classification masalalarida qo'llaniladi.
Keng tarqalgan xato: logistic regression classification algoritmi emas, balki ehtimolni baholovchi vosita ekanini noto'g'ri tushunish.
Linear regression nima va linear regression algoritmlarining qanday farazlari bor?
Linear regression — dependent variable bilan bir yoki bir nechta independent variable o'rtasidagi bog'liqlikni modellashtirish uchun ishlatiladigan statistik usul. Bu supervised machine learning algoritmining bir turi bo'lib, kuzatilgan ma'lumotlarga chiziqli tenglamani fit qilish orqali dependent variable bilan bir yoki bir nechta independent feature o'rtasidagi chiziqli bog'liqlikni hisoblaydi. U independent input variable asosida output variable'larni bashorat qiladi.
Masalan, kimningdir maoshini bashorat qilmoqchi bo'lsangiz, ish tajribasi yillari, ta'lim darajasi, ish sohasi va ish joyi kabi turli omillardan foydalanasiz. Linear regression maoshni bashorat qilish uchun ana shu parametrlarning barchasidan foydalanadi, chunki bu omillarning barchasi bilan uy narxi o'rtasida chiziqli bog'liqlik bor deb hisoblanadi.
Linear regression'ning farazlari quyidagilarni o'z ichiga oladi:
- Linearity: linear regression independent va dependent variable'lar o'rtasida chiziqli bog'liqlik bor deb faraz qiladi. Bu independent variable'dagi o'zgarishlar dependent variable'da ijobiy yoki salbiy yo'nalishda proporsional o'zgarishlarga olib kelishini anglatadi.
- Xatolarning mustaqilligi: kuzatuvlar bir-biridan mustaqil bo'lishi kerak, ya'ni bir kuzatuvdagi xatolar boshqasiga ta'sir qilmasligi lozim.
- Homoscedasticity (teng variance): linear regression xatolarning variance'i independent variable(lar)ning barcha darajalarida o'zgarmas deb faraz qiladi. Bu independent variable(lar)ning qiymati xatolar variance'iga ta'sir qilmasligini bildiradi.
- Residual'larning normalligi: bu residual'lar qo'ng'iroqsimon egri chiziqqa bo'ysunishi kerakligini anglatadi. Agar residual'lar normal taqsimlanmagan bo'lsa, linear regression aniq model bo'lmaydi.
- Multicollinearity yo'qligi: linear regression model uchun tanlangan independent variable'lar o'rtasida correlation yo'q deb faraz qiladi.
SVM (Support Vector Machine) algoritmidagi support vector'lar nima?
Support Vector Machine (SVM) — asosan classification vazifalari uchun ishlatiladigan supervised machine learning algoritmi. U N o'lchovli fazoda data point'larni turli class'larga ajratadigan va har bir class'ning eng yaqin nuqtalari orasidagi margin'ni maksimal qiladigan optimal hyperplane'ni topadi.
Support vector'lar — turli class'larni ajratib turadigan optimal hyperplane'ni aniqlashda yordam beradigan eng muhim data point'lar.
KNN va K-means o'rtasida qanday farq bor?
KNN, ya'ni K-nearest neighbors — classification (yoki regression) algoritmi bo'lib, u biror nuqtaning class'ini aniqlash uchun unga eng yaqin K ta nuqtaning class'larini birlashtiradi. U supervised hisoblanadi, chunki siz nuqtani boshqa nuqtalarning ma'lum class'lari asosida classify qilmoqchi bo'lasiz.
K-means — clustering algoritmi bo'lib, u nuqtalar to'plamini K ta to'plamga (cluster'larga) shunday ajratishga harakat qiladiki, har bir cluster'dagi nuqtalar bir-biriga yaqin joylashadi. U unsupervised hisoblanadi, chunki nuqtalarning tashqaridan berilgan class'i bo'lmaydi.

Quyidagi jadvalda KNN va K-means o'rtasidagi farqlar use case, ma'lumotlardan foydalanish, maqsad va boshqa xususiyatlar bo'yicha ko'rsatilgan.
| Xususiyat | K-Nearest Neighbors (KNN) | K-Means Clustering |
|---|---|---|
| Algoritm turi | Supervised Learning (Classification/Regression) | Unsupervised Learning (Clustering) |
| Maqsad | Label qilingan training data asosida yangi data point'larni classify qiladi | Label qilinmagan data point'larni cluster'larga guruhlaydi |
| Ma'lumotlardan foydalanish | Bashorat uchun butun dataset'dan foydalanadi | Ma'lumotlarni iterativ ravishda cluster'larga ajratadi |
| Scalability | Katta dataset'larda sekin, chunki bashorat uchun barcha data point'lar kerak bo'ladi | Katta dataset'larda tezroq, chunki boshlang'ich centroid'lar allaqachon belgilangan |
| Use case misoli | Image Classification, Recommendation System'lar | Mijozlarni guruhlash |
Bagging va boosting o'rtasida qanday farq bor?
Machine learning'dagi ensemble usullari bir nechta kuchsiz modelni bitta kuchli va aniqroq predictive modelga birlashtiradi hamda unumdorlikni oshirish uchun turli modellarning jamoaviy "aql"idan foydalanadi. Bagging va boosting — xatoni kamaytirish va modelni optimallashtirish uchun bir nechta modeldan foydalanadigan ikki xil ensemble usuli.

Bagging usulida ma'lumotlarning turli qism to'plamlarida train qilingan bir nechta modeldan foydalaniladi. U variance'ni kamaytiradi va overfitting'ning oldini olishga yordam beradi. Odatda decision tree usullariga qo'llaniladi va model averaging yondashuvining xususiy holi hisoblanadi. Boosting esa bir nechta kuchsiz classifier'ni birlashtirib, kuchli classifier yaratishga mo'ljallangan ensemble modeling usuli. Bu jarayonda modellar ketma-ket quriladi va har bir yangi model oldingilari yo'l qo'ygan xatolarni tuzatishga harakat qiladi.
- Bagging: variance'ni kamaytirish uchun bootstrap qilingan dataset'lar yordamida bir nechta modelni parallel ravishda quradi (masalan, Random Forest).
- Boosting: modellarni ketma-ket quradi, ularning har biri oldingisining xatolarini tuzatishga urinadi va shu tariqa bias'ni kamaytiradi (masalan, XGBoost).
Linear regression va logistic regression'ni solishtiring, o'xshash va farqli tomonlarini ko'rsating. Qachon birini boshqasidan afzal ko'rasiz?
Linear regression algoritmi independent va dependent variable'lar o'rtasidagi chiziqli bog'liqlikni aniqlaydi. U masala uchun line of best fit'ni (to'g'ri chiziqni) topishda chiziqli tenglamadan foydalanadi va keyin undan dependent variable'larning natijasini bashorat qilish uchun foydalanadi.

Logistic regression algoritmi dataset'dagi oldingi kuzatuvlar asosida biror hodisaning binary natijasini bashorat qiladi. Uning natijasi 0 va 1 oralig'ida bo'ladi. Algoritm muayyan hodisalarning ro'y berishi yoki ro'y bermasligini bashorat qilish uchun independent variable'lardan foydalanadi.
Natija narx yoki harorat kabi continuous qiymat bo'lganda linear regression'dan foydalanasiz. Natija spam/spam emas, ha/yo'q va shu kabi categorical qiymat bo'lganda esa logistic regression'dan foydalanish kerak.

Regularization (L1 va L2) nima va u nima uchun foydali?
Regularization — machine learning'da modellarning overfitting'ga uchrashining oldini olish usuli. Overfitting model training data'dagi asosiy pattern'lardan (signallardan) o'rganish bilan cheklanib qolmay, undagi shovqinni ham ilib olib, uni kuchaytirganda yuz beradi. Natijada training data'da yaxshi, lekin yangi ma'lumotlarda yomon ishlaydigan model hosil bo'ladi.
L1 va L2 regularization — modelning loss function'iga koeffitsiyentlar bo'yicha penalty hadini qo'shish orqali machine learning modellaridagi overfitting'ni kamaytirish uchun ishlatiladigan usullar. Bu penalty modelni biror bitta feature'ga (katta koeffitsiyentlar bilan ifodalanadigan) haddan tashqari katta ahamiyat berishdan tiyadi va modelni soddaroq qiladi. Regularization modelni muvozanatda va haqiqiy signalga yo'naltirilgan holda saqlaydi hamda uning ko'rilmagan ma'lumotlarga generalize qilish qobiliyatini oshiradi.
L1 regularization usulidan foydalanadigan regression modeli lasso regression, L2'dan foydalanadigan model esa ridge regression deb ataladi.
- L1 Regularization: lasso regression deb ham ataladi; u loss function'ga penalty hadi sifatida koeffitsiyentlar yig'indisining absolyut qiymatini ("absolute value of magnitude") qo'shadi.
- L2 Regularization: ridge regression deb ham ataladi; u loss function'ga penalty hadi sifatida koeffitsiyentlarning kvadratlari yig'indisini ("squared magnitude") qo'shadi.
Precision, recall, F1 score va AUC-ROC nima?
Machine learning modeli yaratilgandan so'ng uning ma'lumotlarda qanchalik yaxshi ishlashini baholash va test qilish muhim. Evaluation metric — model sifatining matematik o'lchovi. Precision, Recall, F1 Score va AUC-ROC — bularning barchasi evaluation metric'lardir.
- Precision positive bashoratlaringiz qanchalik aniq ekanini ko'rsatadi. Modelingiz positive deb label qilgan barcha elementlardan qanchasi haqiqatan ham positive edi? Formula = TP / (TP + FP). U modelingiz topgan positive'larga qanchalik ishonish mumkinligini ko'rsatadi.
- Recall barcha haqiqiy positive'larni topishga e'tibor qaratadi. U modelingiz aniqlashi lozim bo'lgan hamma narsani qanchalik yaxshi aniqlay olishini o'lchaydi. Formula = TP / (TP + FN). U ayniqsa positive holatni o'tkazib yuborish qimmatga tushadigan vaziyatlarda, masalan, saraton tashxisini o'tkazib yuborishda foydali.
- F1 Score: F1 Score Recall va Precision'ni bitta performance metric'ga birlashtiradi. F1 Score — Precision va Recall'ning vaznli o'rtachasi. Shu sababli bu score ham false positive'larni, ham false negative'larni hisobga oladi. F1 odatda Accuracy'dan foydaliroq, ayniqsa class distribution notekis bo'lsa.
- AUC-ROC: AUC-ROC curve — binary classification modellarining unumdorligini baholash vositasi. U turli threshold'larda True Positive Rate (TPR)'ni False Positive Rate (FPR)'ga nisbatan grafikda tasvirlaydi va modelning ikki class'ni, masalan, positive va negative natijalarni bir-biridan qanchalik yaxshi ajrata olishini ko'rsatadi. U modelning ikki class'ni — masalan, kasallik borligini bildiruvchi positive class'ni va kasallik yo'qligini bildiruvchi negative class'ni — farqlay olish qobiliyatini grafik ko'rinishda ifodalaydi.
Izoh: TP = True Positive, FP = False Positive, FN = False Negative.
Confusion matrix nima va uni qanday talqin qilasiz?
Confusion matrix — classification modelining bashoratlarini haqiqiy natijalar bilan solishtirib, u qanchalik yaxshi ishlayotganini ko'rsatadigan oddiy jadval. U bashoratlarni to'rt toifaga ajratadi: ikkala class uchun to'g'ri bashoratlar (true positive va true negative) hamda noto'g'ri bashoratlar (false positive va false negative). Bu model qayerda xato qilayotganini tushunishga va shu orqali uni yaxshilashga yordam beradi.
- TP: True Positives
- TN: True Negatives
- FP: False Positives
- FN: False Negatives
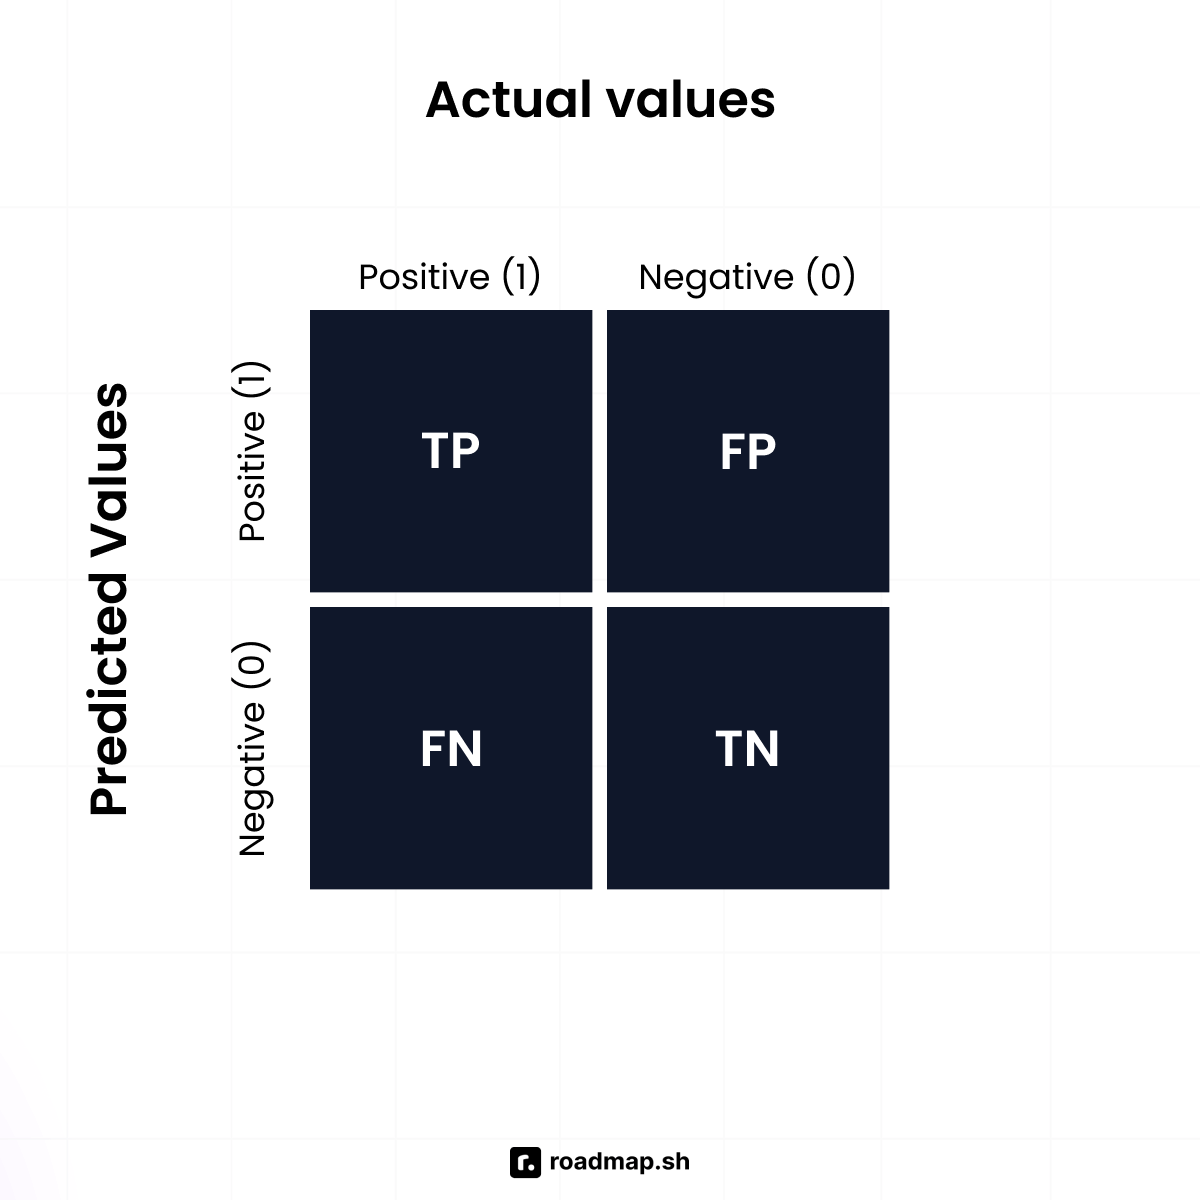
Misol: Quyidagi matritsada jami 165 ta holat bor:
- True Negatives: 50
- False Positives: 10
- False Negatives: 5
- True Positives: 100
Ustida ishlayotgan loyihangizga qarab, uni baholash uchun Accuracy, Precision, Recall va F1 Score kabi metric'lardan foydalanishingiz mumkin. Confusion matrix esa buning vizual ko'rinishidir.

Keng tarqalgan xato: matritsa joylashuvini noto'g'ri o'qish yoki u hech qanday o'zgartirishsiz multi-class holatlarda ham ishlaydi deb o'ylash.
Predictive model qurishda qaysi feature selection usullarini afzal ko'rasiz? Qaysi feature'larni qoldirish yoki olib tashlashni qanday aniqlaysiz?
Predictive model qurishda men amaliy qadamlar va sinovdan o'tgan usullarni birlashtirishni yoqtiraman. Bu men qo'shgan feature'lar shovqin, ortiqchalik yoki overfitting xavfini qo'shish o'rniga, modelga haqiqatan ham yordam berishini ta'minlaydi.
Men shunday yondashaman:
- Soha bilimidan boshlash: biznes kontekstimizda qaysi feature'lar eng mantiqli ekanini tushunish uchun stakeholder'lar bilan gaplashaman va hujjatlarni ko'rib chiqaman.
- Dastlabki saralash uchun filter method'lardan foydalanish: ahamiyatsiz yoki ortiqcha feature'larni olib tashlash uchun correlation, ANOVA, chi-square test'lar yoki mutual information kabi statistik tekshiruvlarni o'tkazaman. Filter method'lar tez ishlaydi, bu ayniqsa high-dimensional ma'lumotlar bilan ishlaganda foydali.
- Unumdorlikni sozlash uchun wrapper method'larni qo'llash: aniqroq tanlov uchun Recursive Feature Elimination (RFE) kabi wrapper method'lardan foydalanaman. Bu usullar feature'larning qism to'plamlarini model ular bilan qanchalik yaxshi ishlashiga qarab baholaydi va eng kuchli bashorat beradigan kombinatsiyalarni aniqlashga yordam beradi. Ular ko'proq vaqt oladi, lekin ta'siri katta bo'lgan modellar uchun bunga arziydi.
- Samaradorlik uchun embedded method'lardan foydalanish: Lasso (L1), Ridge (L2) kabi modellar va tree-based modellarda (Random Forest, XGBoost) ichki o'rnatilgan feature importance mavjud. Men ularni yoqtiraman, chunki ular feature selection'ni model training jarayonining o'zida optimallashtiradi va tezlik bilan accuracy o'rtasida muvozanat saqlaydi.
- Gibrid yondashuv: ba'zan dimension'larni kamaytirish uchun filter method'dan boshlayman, so'ng wrapper yoki embedded method'lar bilan nozik sozlayman. Bu gibrid yondashuv vaqtni tejaydi va unumdorlikni oshiradi.
Nimani olib tashlash yoki qoldirishni qanday hal qilaman:
- Agar feature boshqasi bilan kuchli correlation'ga ega bo'lsa, ulardan kuchsizrog'ini yoki shovqinlirog'ini olib tashlayman.
- Agar uning variance'i past bo'lsa va bashorat qilish kuchi bo'lmasa, u olib tashlanadi.
- Agar u talqin qilishni osonlashtirsa yoki validation data'dagi metric'larni yaxshilasa, uni qoldiraman.
- Agar u generalization'ga zarar yetkazsa yoki murakkablik qo'shsa, uni olib tashlayman.
Confusion matrix'dagi false positive rate va false negative rate o'rtasidagi farqni tushuntiring. Fraud detection ssenariysida bu metric'lar model evaluation'ga qanday ta'sir qiladi?
False Positive Rate (FPR) — haqiqiy negative holatlarning noto'g'ri ravishda positive deb aniqlangan ulushi. False Negative Rate esa haqiqiy positive holatlarning noto'g'ri ravishda negative deb aniqlangan ulushi.
Fraud detection ssenariysida ularning ikkalasi ham jiddiy salbiy oqibatlarga olib keladi:
False Positive Rate (FPR): agar modelning false positive rate'i yuqori bo'lsa, tizim ko'plab qonuniy tranzaksiyalarni firibgarlik deb belgilaydi. Bu mijozlarning noroziligiga olib keladi, chunki ularning tranzaksiyalari muntazam ravishda belgilanib turadi va ular xizmatdan voz kechib ketishi mumkin.
False Negative Rate (FNR): agar modelning false negative rate'i yuqori bo'lsa, ko'plab firibgarlik tranzaksiyalari aniqlanmay qoladi va bu biznes uchun jiddiy moliyaviy yo'qotishlarga olib kelishi mumkin.
Kodlash masalalari
Xodimlar jadvalidan ikkinchi eng yuqori maoshni olish uchun SQL query yozing.
Ikkinchi eng yuqori maoshni topish uchun ikki keng tarqalgan usuldan birini qo'llashingiz mumkin: subquery yoki window function.
1-usul: Subquery usuli Avval jadvaldagi maksimal maoshni olasiz. So'ng shu maksimaldan kichik bo'lgan eng yuqori maoshni topasiz — bu sizga ikkinchi eng yuqori maoshni beradi.
Bu usul toza va samarali:
SELECT MAX(salary) AS SecondHighest
FROM employee
WHERE salary < (SELECT MAX(salary) FROM employee);
2-usul: DENSE_RANK() bilan window function DENSE_RANK() yordamida barcha maoshlarni kamayish tartibida rank qilasiz, so'ng ikkinchi eng yuqori maoshni olish uchun rank 2 bo'yicha filter qilasiz. LIMIT 1 bir xil qiymatlar bo'lgan taqdirda faqat bitta satr qaytarilishini ta'minlaydi. Agar uchinchi, to'rtinchi va hokazo eng yuqori maoshni tanlamoqchi bo'lsangiz, bu usul moslashuvchanligi tufayli yaxshiroq.
SELECT salary AS SecondHighest
FROM (
  SELECT salary, DENSE_RANK() OVER (ORDER BY salary DESC) as rank
  FROM employee
) ranked
WHERE rank = 2
LIMIT 1;
Buyurtmalarni mijozlar ma'lumotlari bilan birlashtirish
Buyurtma tafsilotlarini tegishli mijoz ma'lumotlari bilan birlashtirish uchun oddiy inner join'dan foydalanasiz:
SELECT o.*, c.name, c.email
FROM orders o
JOIN customers c ON o.customer_id = c.id;
Bu mos mijozi mavjud bo'lgan barcha buyurtmalarni olib keladi. Agar sizga har bir buyurtma, jumladan mos mijozi bo'lmaganlari ham kerak bo'lsa, LEFT JOIN'ga o'ting:
SELECT o.*, c.name, c.email
FROM orders o
LEFT JOIN customers c ON o.customer_id = c.id;
Daromad bo'yicha top 5 mijozni topadigan SQL query yozing.
Eng ko'p pul sarflagan mijozlarni olish uchun mijoz bo'yicha guruhlang, ularning buyurtmalari summasini qo'shing, shu summa bo'yicha saralang va natijalar sonini cheklang:
SELECT customer_id, SUM(total_amount) AS revenue
FROM orders
GROUP BY customer_id
ORDER BY revenue DESC
LIMIT 5;
Mijozlar ismini qo'shish uchun shunchaki customers jadvali bilan join qiling.
Keng tarqalgan xato: saralashdan oldin to'g'ri guruhlamaslik noto'g'ri aggregate natijalarga olib kelishi mumkin.
O'tgan chorakda xarid summasi bo'yicha top beshta mijozni topadigan SQL query yozing.
Bir nechta kategoriyadan xarid qilgan top mijozlaringizni topish uchun xaridlarni so'nggi 3 oy bo'yicha filter qiling, mijoz bo'yicha guruhlang va HAVING yordamida kategoriya cheklovlarini qo'llang:
SELECT customer_id, SUM(amount) AS total_spent
FROM purchases
WHERE purchase_date >= DATE_SUB(CURDATE(), INTERVAL 3 MONTH)
GROUP BY customer_id
HAVING COUNT(DISTINCT category_id) >= 3
ORDER BY total_spent DESC
LIMIT 5;
Bu har bir mijoz kamida 3 ta kategoriyadan xarid qilganini ta'minlaydi. WHERE satrlarni guruhlashdan oldin filter qiladi, HAVING esa guruhlarni guruhlashdan keyin filter qiladi.
DataFrame'dan dublikatlarni qanday olib tashlaysiz?
DataFrame'dan dublikatlarni olib tashlash uchun:
df = df.drop_duplicates()
Shuningdek, ustunlarni ko'rsatib, buni aniqroq sozlashingiz mumkin:
# Drop duplicates based on specific columns
df = df.drop_duplicates(subset=['customer_id', 'product_id'])
Qaysi dublikatlarni qoldirishni boshqarish:
# Keep first or last occurrence
df = df.drop_duplicates(keep='last')  # or 'first'
Ma'lumotlar stream'i berilgan bo'lsa, medianani real vaqtda qanday topgan bo'lardingiz?
Sonlar stream'ida medianani hisoblash uchun ikkita heap'dan foydalaning:
- Pastki yarmi uchun max-heap
- Yuqori yarmi uchun min-heap
- Ikkala heap'ni muvozanatda saqlang
- Mediana yo heap'lardan birining tepasidagi element, yoki ikkala tepa elementning o'rtachasi bo'ladi
import heapq

class MedianFinder:
    def __init__(self):
        self.small = []  # max heap (negative values)
        self.large = []  # min heap

    def add_num(self, num):
        if len(self.small) == len(self.large):
            heapq.heappush(self.large, -heapq.heappushpop(self.small, -num))
        else:
            heapq.heappush(self.small, -heapq.heappushpop(self.large, num))

    def find_median(self):
        if len(self.small) == len(self.large):
            return (self.large[0] - self.small[0]) / 2.0
        else:
            return self.large[0]
Ustma-ust tushadigan intervallarni birlashtirish
Ustma-ust tushadigan intervallarni birlashtirish uchun avval ularni saralang, so'ng ular bo'ylab iteratsiya qilib, kerak bo'lganda birlashtiring:
def merge_intervals(intervals):
    intervals.sort(key=lambda x: x[0])
    merged = [intervals[0]]
    for current in intervals[1:]:
        last = merged[-1]
        if current[0] <= last[1]:
            last[1] = max(last[1], current[1])
        else:
            merged.append(current)
    return merged
Saralash O(n log n) vaqt oladi, birlashtirish bosqichi esa chiziqli, shuning uchun bu usul katta dataset'lar uchun samarali.
pandas'da null qiymatlar bilan qanday ishlaysiz?
Null qiymatlar bilan ishlashning asosiy usullari:
df.fillna(0)      # Replace with 0
df.dropna()       # Drop rows with nulls
Ko'rib chiqish mumkin bo'lgan boshqa usullar:
# Fill with mean/median/mode
df['column'].fillna(df['column'].mean())
df['column'].fillna(df['column'].median())
df['column'].fillna(df['column'].mode()[0])

# Forward/backward fill
df.fillna(method='ffill')  # Use previous value
df.fillna(method='bfill')  # Use next value

# Interpolation
df.interpolate()
Python'da ma'lumotlarni qanday guruhlab, aggregation qilgan bo'lardingiz?
Oddiy guruhlash va yig'indini hisoblash:
df.groupby('category')['sales'].sum()
Murakkabroq aggregation'lar uchun:
# Multiple aggregations
df.groupby('category').agg({
    'sales': ['sum', 'mean', 'count'],
    'profit': ['min', 'max']
})

# Custom aggregation functions
df.groupby('category')['sales'].agg(lambda x: x.max() - x.min())

# Reset index to convert back to a regular DataFrame
df.groupby('category')['sales'].sum().reset_index()
Nima uchun SQL'da RANK() tartib raqamlarini o'tkazib yuboradi?
Given values: 100, 90, 90, 80
RANK(): Skips ranks after ties
→ 1, 2, 2, 4
DENSE_RANK(): No skipping
→ 1, 2, 2, 3
ROW_NUMBER(): Ignores ties
→ 1, 2, 3, 4
LEFT JOIN yetarli bo'lsa, nega RIGHT JOIN ishlatiladi?
RIGHT JOIN jadvallar tartibi teskari qilingan LEFT JOIN bilan bir xil:
SELECT * FROM A RIGHT JOIN B ON A.id = B.id;
SELECT * FROM B LEFT JOIN A ON A.id = B.id;
pandas'dagi .apply() va .map() o'rtasida qanday farq bor?
- .map(): faqat Series bilan ishlaydi va funksiyani har bir elementga alohida qo'llaydi
- .apply(): ko'proq imkoniyatga ega, ham Series, ham DataFrame bilan ishlaydi
- .applymap(): funksiyani DataFrame'dagi har bir elementga qo'llaydi
# map - simple transformation of Series values
df['category'] = df['category_id'].map({1: 'Electronics', 2: 'Clothing'})

# apply on Series - more complex operations
df['name'] = df['name'].apply(lambda x: x.title())

# apply on DataFrame - process entire rows or columns
df.apply(lambda x: x.max() - x.min())

# applymap - element-wise operation on entire DataFrame
df.applymap(lambda x: f"{x:.2f}" if isinstance(x, float) else x)
Python'da K-Means clustering'ni qanday amalga oshirgan bo'lardingiz?
Oddiy foydalanish:
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=3).fit(X)
labels = kmeans.labels_
K-Means uchun best practice'lar:
# Scale features
from sklearn.preprocessing import StandardScaler
X_scaled = StandardScaler().fit_transform(X)

# Use elbow method to find optimal k
distortions = []
K_range = range(1, 10)
for k in K_range:
    kmeans = KMeans(n_clusters=k, random_state=42)
    kmeans.fit(X_scaled)
    distortions.append(kmeans.inertia_)

# Plot elbow curve
import matplotlib.pyplot as plt
plt.plot(K_range, distortions)
plt.xlabel('k')
plt.ylabel('Distortion')
plt.title('Elbow Method For Optimal k')
Linear regression modelida RMSE va MSE'ni qanday topasiz?
Regression modelini baholash uchun:
from sklearn.metrics import mean_squared_error
import numpy as np
mse = mean_squared_error(y_true, y_pred)
rmse = np.sqrt(mse)
- MSE: katta xatolarni qattiq jazolaydi.
- RMSE: talqin qilish osonroq, chunki u target bilan bir xil o'lchov birligida bo'ladi.
Yana bir muqobil variant:
from sklearn.metrics import mean_absolute_error
mae = mean_absolute_error(y_true, y_pred)
MAE outlier'larga kamroq sezgir.
Confusion matrix yordamida accuracy'ni qanday hisoblash mumkin?
accuracy = (TP + TN) / (TP + TN + FP + FN)
precision = TP / (TP + FP)  # How many selected items are relevant
recall = TP / (TP + FN)     # How many relevant items are selected
f1_score = 2 * (precision * recall) / (precision + recall)  # Harmonic mean

# For imbalanced datasets, consider:
specificity = TN / (TN + FP)
balanced_accuracy = (recall + specificity) / 2
Real biznes ssenariylari
Yangi mahsulot chiqarilishining muvaffaqiyatini qanday o'lchagan bo'lardingiz?
Avvalo, aynan shu mahsulot chiqarilishi uchun muvaffaqiyat nimani anglatishini aniqlab oling. Bu 30 kun ichida 1,000 ta yangi foydalanuvchi jalb qilishmi? Daromad yoki CTR bo'yicha maqsadga erishishmi? Yangi bozorda xabardorlikni oshirishmi? Yoki kelajakdagi yaxshilanishlar uchun fikr-mulohazalar yig'ishmi?
Bu aniq bo'lgach, muvaffaqiyatni marketing, product va customer success kabi jamoalar bo'yicha miqdoriy va sifat KPI'larining aralashmasi yordamida o'lchang. Men qaraydigan ba'zi metric'lar:
- Launch kampaniyasi metric'lari: marketing samaradorligini baholash uchun yaratilgan lead'lar, kanallar samaradorligi (email, reklama, ijtimoiy tarmoqlar), veb-sayt traffic'i va matbuotda yoritilishiga qarang.
- Product adoption metric'lari: launch'dan keyin trial'lar, foydalanish, activation va user retention'ni kuzatib boring. Ular mahsulot maqsadli auditoriyangiz tomonidan qanchalik yaxshi qabul qilinayotganini ko'rsatadi.
- Bozorga ta'sir metric'lari: biznesga ta'sirni daromad, bozor ulushi va raqobatchilarga nisbatan win rate'lar orqali o'lchang.
- Sifat jihatidan fikr-mulohazalar: savdo vakillari, product jamoalari va mijozlar bilan suhbatlashing. Ichki va tashqi fikr-mulohazalar raqamlar ortidagi "nima uchun"ni tushunishga yordam beradi. Ma'lumotlarni bevosita fikr-mulohazalar bilan uyg'unlashtirish nima ishlayotgani va nimani yaxshilash kerakligi haqida shaffofroq va chuqurroq tasavvur beradi.
Keng tarqalgan xato: faqat miqdoriy metric'larga e'tibor qaratib, ularni chuqurroq talqin qilmaslik. Masalan, engagement'ni kuzatmasdan yuklab olishlar soni kabi metric'larni kuzatish. Yoki kim ko'rayotganini bilmasdan ko'rishlar sonini kuzatish.
Veb-sayt traffic'i to'satdan pasayib ketganini sezdingiz. Sababini qanday tekshirgan bo'lardingiz?
Veb-sayt traffic'ining to'satdan pasayishini tahlil qilish uchun men quyidagi qadamlarni bajarardim:
- Bu bir martalik pasayishmi yoki trendmi, aniqlang: birinchi navbatda traffic'ingiz bir muddatdan beri kamayib kelyaptimi yoki bir-ikki kun ichida to'satdan tushib ketdimi, shuni tushunishga harakat qiling.
- Manual action'larni istisno qiling: ba'zan traffic Google penalty'si tufayli pasayadi. Qoidalarga yaqinda kiritilgan va siz buzgan bo'lishingiz mumkin bo'lgan o'zgarishlar bor-yo'qligini tekshiring. Shuningdek, veb-saytingiz kontentiga kiritgan yangilanishlaringiz muammo keltirib chiqarmaganiga ishonch hosil qiling.
- Algoritm yangilanishlarini tekshiring: Google o'zining ranking algoritmini tez-tez yangilab turadi. Saytingiz ko'rsatkichlari to'satdan pasayganda, bunga biror yangilanish sabab bo'lgan-bo'lmaganini tekshirib ko'rishga arziydi.
- Texnik muammolarni o'rganing: eng keng tarqalgan texnik muammolar qatoriga indexing xatolari, sayt tezligi, unumdorlik va mobil qurilmalardagi usability kiradi.
- Raqobatchilar faolligini tekshiring: ba'zan traffic raqobatchilar faolligini oshirgani sababli pasayadi. Ahrefs, SEMrush yoki Moz kabi SEO vositalari raqobatchilaringizning backlink'lari, keyword'lari va ranking'larini kuzatishga yordam beradi. Raqobatchilaringiz avval siz egallab turgan keyword'lar bo'yicha sizdan yuqoriga chiqib olganmi yoki asosiy auditoriyangizga qaratilgan yangi kontent chiqarganmi, tekshirib ko'ring.
Model accuracy'si 95% bo'lsa-yu, biznes natijalardan norozi bo'lsa-chi?
Biznes accuracy'si yuqori bo'lgan modeldan norozi bo'lishining bir nechta sababi bo'lishi mumkin. Ulardan ba'zilari:
- Noto'g'ri metric'ga e'tibor qaratish: ba'zan model aynan shu biznes muammosi uchun optimallashtirilmagan bo'ladi. Uning accuracy'si noto'g'ri narsaga bog'langan. Masalan, fraud detection'da accuracy score'lari yuqori bo'lsa ham, firibgarlik tranzaksiyalarini o'tkazib yuborish mumkin.
- Real bo'lmagan kutilmalar: modeldan muammolarni hal qilishda haddan tashqari ko'p narsa kutilayotgan bo'lishi mumkin, holbuki aslida u chuqurroq tasavvur berish uchun boshqa usullar va metric'lar bilan birgalikda ishlatilishi kerak.
- Overfitting: yuqori accuracy model generalize qilishni o'rganish o'rniga training data'ni yodlab olgani natijasida yuzaga kelgan bo'lishi mumkin.
Bu muammoni hal qilish uchun men:
- Biznes maqsadlarini qayta baholayman: ba'zan model aynan qaysi metric yoki metric'lar guruhiga qarab train qilinishi kerakligini belgilash uchun biznes maqsadlarini aniq belgilab olish kerak bo'ladi.
- Model unumdorligini yaxshilayman: modelni chuqur o'rganib chiqib, overfitting, ma'lumotlar bilan bog'liq muammolar yoki feature selection kabi sezgan har qanday kamchilikni tuzatish kerak.
Sizga tasodifiy dataset berildi. Uning foydali ekanini qanday tekshirasiz?
Tasodifiy dataset sifatini tekshirish uchun men:
-
Muammo kontekstini tushunaman: dataset'ga qarashdan oldin birinchi navbatda qanday maqsadga erishmoqchi ekaningizni yaxshi tushunib olishingiz kerak. Bu dataset muammoga mos keladimi-yo'qmi, birinchi qarashdayoq bilish imkonini beradi. Agar ma'lumotlarda ahamiyatsiz ustunlar bo'lsa, ularni olib tashlash kerak.
-
Ma'lumotlar sifatini tekshiraman: siz hal qilayotgan har qanday muammo, katta ehtimol bilan, avval ham hal qilingan. Ma'lumotlardagi har qanday chetlanishlarni o'lchash uchun dataset'ingizni ishonchli dataset bilan solishtirib tekshirishingiz mumkin. Dataset real hayotdagi ssenariylarni ham aks ettirishi kerak.
-
Texnik tekshiruvlar: texnik tekshiruvlarda ma'lumotlardagi dublikatlarni olib tashlash maqsadga muvofiq. Xira tasvirlar yoki noto'g'ri label qilingan sample'lar ko'rinishida shovqin bo'lishi mumkin. Shuningdek, hamma narsa to'g'ri va bir xil formatda ekaniga ishonch hosil qilishingiz kerak.
-
Amaliy foydaliligini baholayman: dataset siz bajarmoqchi bo'lgan vazifa uchun yetarlicha katta bo'lishi kerak. An'anaviy machine learning uchun dataset hajmi har bir class'dagi feature'lar sonidan 10 baravardan ko'proq katta bo'lishi kerak. Deep learning uchun esa overfitting'ning oldini olishga yordam berishi uchun har bir class'ga 100 ta feature'ni maqsad qilish kerak.
Dataset faqat muammoning konteksti va maqsadlariga mos kelgandagina foydali bo'ladi. U aniqlik, to'liqlik va muvozanat bo'yicha tekshiruvlardan o'tishi shart. Nihoyat, u hajm va reprezentativlik talablariga javob berishi kerak.
Tibbiy diagnostika uchun classification modelini qanday baholagan bo'lardingiz?
Sog'liqni saqlash sohasidagi classification modellari bemorlarga oid katta hajmdagi ma'lumotlarni tahlil qilish uchun machine learning'dan foydalanadi. Ular murakkab pattern'lar va bog'liqliklarni aniqlab, tibbiyot xodimlariga sog'liq bilan bog'liq xavflarni aniqroq bashorat qilishda yordam beradi. Bu modellar shifokorlarga to'g'ri qaror qabul qilishga va diagnostik xatolarni kamaytirishga ko'maklashadi. Classification modellarini baholash uchun qaysi metric'lardan foydalanish to'g'riligini bilishingiz kerak.
- Accuracy, sensitivity va specificity metric'lari: accuracy, sensitivity va specificity tibbiy modellarni baholashda hal qiluvchi ahamiyatga ega. Accuracy bashoratlarning umumiy to'g'riligini o'lchaydi. Sensitivity, ya'ni recall, modelning positive holatlarni aniqlash qobiliyatini ko'rsatadi. Specificity esa u negative holatlarni qanchalik yaxshi aniqlashini bildiradi. Bu metric'lar turli tibbiyot sohalarida diagnostika aniqligini baholash uchun juda muhim.
- ROC curve'lar va AUC tahlili: ROC curve'lar va AUC tahlili sog'liqni saqlashdagi AI unumdorligi uchun asosiy metric'lardir. Ular modelning turli threshold'larda class'larni bir-biridan ajrata olish qobiliyatini baholaydi. AUC score qanchalik yuqori bo'lsa, model positive va negative holatlarni shunchalik yaxshi farqlaydi.
- Cross-validation usullari: cross-validation modelning ko'rilmagan ma'lumotlardagi unumdorligini baholaydi. k-fold cross-validation kabi usullar ma'lumotlarni training va testing uchun qism to'plamlarga ajratadi va modelning generalize qilish qobiliyatini ishonchli baholash imkonini beradi.
Batch learning va online learning o'rtasida qanday farq bor?
Batch learning — sun'iy intellektdagi atama bo'lib, u machine learning modelini yangi ma'lumotlar kelib tushgan sari uzluksiz yangilab borish o'rniga, katta hajmdagi ma'lumotlar to'plamida bir yo'la train qilish jarayonini anglatadi. Bu usul training jarayonida ko'proq barqarorlik va samaradorlikni ta'minlaydi, chunki model foydalanish uchun deploy qilinishidan oldin qat'iy belgilangan ma'lumotlar to'plamidan o'rganib oladi.
Batch learning'da model butun dataset'ni bir necha marta ko'rib chiqadi (bu epoch'lar deb ataladi) va har bir o'tishda o'z tushunchasini aniqlashtirib boradi. Ma'lumotlarni katta bo'laklarda qayta ishlagani sababli u sekinroq converge qiladi, ammo odatda yuqoriroq accuracy'ga erishadi.
Online learning esa uzluksiz, bosqichma-bosqich yondashuvni qo'llaydi. Barcha ma'lumotlar tayyor bo'lishini kutish o'rniga, siz ularni modelga oz-ozdan berib borasiz — xuddi yakuniy imtihon oldidan hammasini bir kechada yodlash o'rniga har kuni yangi narsa o'rganishga o'xshaydi. Model har bir yangi data point bilan yangilanadi, shuning uchun u doimiy ravishda o'rganib, rivojlanib boradi.
Masalan, veb-saytda mijozlar xatti-harakatini kuzatayotganingizni tasavvur qiling. Har safar foydalanuvchi biror narsani bosganida yoki xarid qilganida modelingiz "aqlliroq" bo'ladi: u o'sha bitta harakatdan o'rganadi va keyingisi uchun bashoratlarini aniqlashtiradi.
Deep learning'ning an'anaviy ML'ga nisbatan afzalliklari va kamchiliklari qanday?
Deep learning image recognition, NLP va recommendation system'lar kabi murakkab vazifalarni hal qilish uchun ko'p qatlamli neural network'lardan foydalanadi. Bunga CNN, RNN va Transformer'larni misol qilish mumkin.
Afzalliklari:
- Murakkab, high-dimensional ma'lumotlar (tasvirlar, audio, matn) bilan ishlay oladi
- Ham structured, ham unstructured ma'lumotlar bilan ishlaydi
- Non-linear bog'liqliklarni o'rganadi
- Transfer learning kabi usullar yordamida turli use case'larga yaxshi scale qilinadi
- Katta dataset'lardan generalize qilishda juda yaxshi
Kamchiliklari:
- Ko'p ma'lumot va hisoblash resurslarini talab qiladi
- Ma'lumotlar sifatiga kuchli bog'liq
- Talqin qilish qiyin (black box)
- Maxfiylik va xavfsizlik bilan bog'liq xavotirlarni keltirib chiqaradi
An'anaviy ML esa decision tree'lar, logistic regression va support vector machine'lar kabi soddaroq va talqin qilish osonroq bo'lgan algoritmlardan foydalanadi.
Afzalliklari:
- Kichikroq dataset'lar bilan yaxshi ishlaydi
- Tezroq train qilinadi va talqin qilish osonroq
- Hisoblash xarajati pastroq
- Shaffofroq va tushuntirish osonroq
Kamchiliklari:
- Murakkab/non-linear ma'lumotlar bilan qiynaladi
- Qo'lda feature engineering qilishni talab qiladi
- Katta dataset'larda yaxshi scale qilinmaydi
- To'g'ri tune qilinmasa, overfit bo'lishi mumkin
Production'da model unumdorligini qanday monitoring qilasiz?
Production'da model unumdorligini funksional va operatsion metric'larni kuzatib borish orqali monitoring qilasiz.
Funksional monitoring ma'lumotlar va modelning holatini tekshiradi:
- Ma'lumotlar sifati: missing value'lar, dublikatlar va sintaksis xatolarini kuzatib boring.
- Data/feature drift: KL divergence, PSI, chi-squared va boshqa statistik ko'rsatkichlar yordamida joriy input ma'lumotlarini training data bilan solishtiring.
- Model drift: ma'lumotlardagi pattern'lar o'zgarishi sababli model accuracy'si vaqt o'tishi bilan pasayayotganini tekshiring.
Operatsion monitoring tizimning uzluksiz ishlashini ta'minlaydi:
- Tizim holati: latency, xatolar va xotiradan foydalanishni kuzatadi.
- Input ma'lumotlar holati: type nomuvofiqliklari, null'lar va ruxsat etilgan oraliqdan tashqaridagi qiymatlarni kuzatib boring.
- Model unumdorligi: use case'ga qarab precision/recall, RMSE yoki top-k accuracy'dan foydalaning.
- Biznes KPI'lari: model unumdorligini real biznes natijalari bilan bog'lang (masalan, konversiyalar, daromadga ta'sir).
Murakkab mavzular
Modelingizdagi concept drift'ni qanday aniqlagan bo'lardingiz?
Concept drift input feature'lar bilan target variable o'rtasidagi bog'liqlik vaqt o'tishi bilan o'zgarganda yuzaga keladi va modelingiz unumdorligining pasayishiga sabab bo'ladi. Bu dinamik muhitlarda (masalan, foydalanuvchilar xatti-harakati, bozor trendlari) keng tarqalgan. COVID-19 bunga real hayotdan misol bo'la oladi: pandemiyadan oldin train qilingan modellar ishdan chiqdi, chunki xatti-harakatlar va ma'lumotlardagi pattern'lar o'zgarib ketdi.
Uni qanday aniqlash mumkin:
- Reference va detection window'larini belgilang: o'tmishdagi barqaror dataset'ni (masalan, yanvar oyidagi traffic) joriy window bilan (masalan, shu hafta) solishtiring. Bu sizga baseline beradi.
- Distribution'larni solishtiring: ma'lumotlar yoki feature distribution'laridagi siljishlarni aniqlash uchun statistik testlardan (masalan, Kolmogorov–Smirnov, PSI, KL divergence) foydalaning.
- Model unumdorligini vaqt davomida kuzatib boring: baseline'ga nisbatan precision, recall yoki umumiy accuracy'ning pasayishi = xavf belgisi.
- Significance test'larni o'tkazing: ular drift haqiqiymi yoki shunchaki shovqinmi, shuni ko'rsatadi.
Modellaringizda fairness'ni qanday ta'minlaysiz va bias'ni qanday bartaraf etasiz?
Fairness modelingiz hech bir guruhga nohaq imtiyoz bermaydigan yoki uni nohaq jazolamaydigan qarorlar qabul qilishini anglatadi. Bias istalgan bosqichda — ma'lumotlarni yig'ish, labeling, training va hatto deployment jarayonida ham — sezdirmay kirib qolishi mumkin, shuning uchun u bilan erta va muntazam shug'ullanish kerak.
Fairness'ni qanday ta'minlash mumkin:
- Xilma-xil training data'dan boshlang: ma'lumotlaringiz modelingiz ta'sir qiladigan barcha guruhlarni aks ettirishi kerak. Agar ular bir tomonga og'gan bo'lsa, model ham shunday bo'ladi.
- Vakillikni muvozanatlash uchun preprocessing qiling: kam vakil qilingan guruhlarni oversampling qilish yoki ma'lumotlarni reweighting qilish kabi usullardan foydalaning.
- Bias detection vositalaridan foydalaning: Fairlearn, AIF360 va What-If Tool kabi kutubxonalar subgroup'lar bo'yicha unumdorlikdagi farqlarni aniqlashga yordam beradi.
- Training vaqtida fairness cheklovlarini qo'llang: muayyan guruhlarga yetadigan zararni kamaytirish uchun regularization, adversarial debiasing yoki post-processing tuzatishlaridan foydalaning.
- Modelga shaffoflikni joriy qiling: talqin qilinadigan modellardan (masalan, decision tree'lar, linear modellar) yoki SHAP va LIME kabi tushuntirish vositalaridan foydalaning.
- Subgroup'lar bo'yicha muntazam audit o'tkazing: faqat umumiy accuracy'ga tayanmang — jins, irq, yosh va boshqalar bo'yicha unumdorlikka qarang.
- Inson nazoratini jalb qiling: odamlar har doim jarayonning bir qismi bo'lishi kerak, ayniqsa yuqori xavfli qarorlarda (masalan, kredit berish, ishga qabul qilish).
Qaysi biri yaxshiroq: modelni fine-tuning orqali ixtisoslashtirishmi yoki ko'proq ma'lumot bilan uni umumlashtirishmi?
Fine-tuning — pre-trained modelni muayyan vazifalar yoki use case'larga moslashtirish jarayoni. Fine-tuning'ning mantiqi shundaki, vazifa haqida allaqachon keng bilim o'rganib olgan pre-trained base modelning imkoniyatlarini yaxshilash yangi modelni noldan train qilishdan osonroq va arzonroq.
Generalization — modelingiz ko'rilmagan ma'lumotlarni bashorat qilishda qanchalik yaxshi ishlashining o'lchovi. Ko'proq ma'lumot bilan generalize qilish — modelning o'zi train qilingan ma'lumotlarda emas, balki yangi ma'lumotlarda bashorat qilish qobiliyatini yaxshilash demakdir.
Maqsadingizga erishish uchun ko'proq ma'lumot bilan generalize qilishni yoki fine-tuning'ni tanlash aniq vaziyatga bog'liq.
Fine-tuning orqali ixtisoslashtirish:
- Juda aniq bir vazifa yoki sohada yuqori unumdorlik kerak bo'lganda yaxshiroq.
- Resurslaringiz cheklangan, lekin muayyan vazifa uchun sifatli ma'lumotlaringiz bo'lganda samaraliroq.
- Kichikroq modellar bilan ham kuchli natijalarga erishish mumkin.
Ko'proq ma'lumot bilan generalize qilish:
- Keng doiradagi vazifalarni bajarishi kerak bo'lgan modellar uchun yaxshiroq.
- Overfitting muammo bo'ladigan vaziyatlar uchun juda mos.