Kubernetes bo'yicha eng muhim 50 ta intervyu savoli va javoblari
Navbatdagi Kubernetes intervyusidan a'lo darajada o'tmoqchimisiz? Ko'p so'raladigan ushbu Kubernetes intervyu savollari bilan tayyorgarlik ko'ring.
Muallif: Ekene Eze
Kubernetes DevOps va backend engineering vakansiyalari tavsiflarida uchrab turishda davom etmoqda va bu tendensiya sekinlashish alomatlarini ko'rsatmayapti. Cloud computing o'sishda davom etar ekan, Kubernetes ilovalarni katta miqyosda deploy qilish va boshqarish uchun keng qo'llaniladigan tanlovga aylandi. Engineer yollayotgan intervyu oluvchilar chuqurlikni izlashadi. Shunchaki bilimni emas, balki siz outage'larni bartaraf etganingiz, noto'g'ri konfiguratsiyalarni to'g'rilaganingiz va xavfsizlik muammolarini tuzatganingizning isbotini.
Ammo ko'pchilik e'tibordan chetda qoldiradigan jihat bor. Intervyu oluvchilarni pod nima ekanini so'zma-so'z aytib bera olishingiz qiziqtirmaydi. Ularni qanday fikrlashingiz qiziqtiradi. Deployment nima uchun muvaffaqiyatsiz bo'lganini tushuntirib bera olasizmi? Bosim ostida hamma narsa buzilganda scaling muammolarini mantiqan tahlil qila olasizmi?
Shu sababli biz tajriba darajasi bo'yicha guruhlangan 50 ta Kubernetes intervyu savoli va javobini tayyorladik: boshlang'ich, o'rta va yuqori daraja. Ushbu qo'llanma asosiy tushunchalarni qayta ko'rib chiqish, zaif tomonlaringizni aniqlash va agar o'sha lavozimni egallashni jiddiy maqsad qilgan bo'lsangiz, tayyorgarlik ko'rishga yordam berish uchun mo'ljallangan.
TL;DR
Boshlang'ich, o'rta va yuqori darajalarga guruhlangan 50 ta Kubernetes intervyu savolini o'rganing.
-
Asosiy mavzular qatoriga Kubernetes arxitekturasi, pod'lar, node'lar, service'lar, scheduling, networking, scaling, storage, RBAC, xavfsizlik va cluster boshqaruvi kiradi.
-
Asosiy va murakkab mavzular bo'yicha tushunchangizni mustahkamlash hamda keyin aynan nimani o'rganish kerakligini bilish uchun Kubernetes roadmap'ini o'rganib chiqing.
-
Bundan ham ilgarilash uchun AI Tutor yordamida savollar bering, tushunchalarni anglab oling, o'sishingizni kuzatib boring va shaxsiylashtirilgan o'quv maslahatlarini oling.
Kubernetes intervyusiga tayyorlanish bo'yicha maslahatlar
Kubernetes intervyulari tizimlarning production'da o'zini qanday tutishiga e'tibor qaratadi, masalan, node ishdan chiqqanda pod qanday tiklanadi yoki service ishlamay qolganda traffic qanday yo'naltiriladi. Buni tushunishning o'zi sizni ko'pchilik nomzodlardan oldinga chiqaradi.
Tushunchalarni ta'riflar bilan emas, real ssenariylar orqali tushuntiring. Bu texnologiya haqida shunchaki o'qib qolmay, u bilan haqiqatan ishlaganingizni ko'rsatadi.
Kubernetes node nosozliklarini qanday hal qilishini o'rganishga vaqt ajrating. CrashLoopBackOff, buzilgan Ingress yoki service'lar va RBAC misconfiguration'lari production'da uchrab turadi. Debugging jarayoningizni bosqichma-bosqich tushuntirib berishga tayyor bo'ling.
Flashcard'lar bilan o'zingizni sinab ko'ring
Siz ushbu flashcard'lardan foydalanishingiz yoki savollarni ro'yxat ko'rinishida ko'rish uchun quyidagi savollar ro'yxati bo'limiga o'tishingiz mumkin.
Savollar ro'yxati
Agar savollarni ro'yxat ko'rinishida ko'rishni afzal ko'rsangiz, ularni quyida topishingiz mumkin.
Boshlang'ich darajadagi Kubernetes intervyu savollari va javoblari
Kubernetes nima va u nima uchun ishlatiladi?
K8s nomi bilan ham tanilgan Kubernetes — containerized ilovalarni deploy qilish, boshqarish va scaling qilish uchun open source container orchestration platformasi. Container'larni serverlar bo'ylab qo'lda boshqarib yurish o'rniga, Kubernetes scheduling'ni avtomatlashtiradi, scaling'ni yaxshilaydi va ilovalaringizning uzluksiz ishlab turishini ta'minlaydi.
Dasturchilar Kubernetes'dan downtime'ning oldini olish hamda rolling update'lar, service discovery va fault tolerance kabi murakkab jarayonlarni boshqarish uchun foydalanadi, shunda siz infratuzilmadagi favqulodda muammolarni o'chirish bilan emas, feature'lar yaratish bilan shug'ullanishingiz mumkin.
Kubernetes'da pod nima?
Pod — Kubernetes'dagi eng kichik deploy qilinadigan birlik. U bitta network namespace'da ishlaydigan bir yoki bir nechta container'ni o'z ichiga oladi. Bu container'lar storage va networking resurslarini, masalan, yagona IP address'ni birgalikda ishlatadi, bu esa bir-biriga qattiq bog'langan container'larning birga ishlashiga imkon beradi.
Asosiy container — ilovangiz joylashadigan joy. Pod'lar yana ikki turdagi container'ni qo'llab-quvvatlaydi:
-
Init container asosiy container ishga tushishidan oldin ishlaydi va dependency'larni tekshirish kabi tayyorgarlik vazifalarini bajaradi.
-
Sidecar container asosiy container bilan yonma-yon ishlaydi va asosiy ilovaga tegmagan holda logging yoki proxying kabi yordamchi vazifalarni bajaradi.
Kubernetes'da node nima?
Node — Kubernetes cluster'idagi mashina. Worker node'lar — pod'lar aslida ishlaydigan joy. Har bir cluster ikki asosiy qismdan iborat:
-
Control plane cluster holatini boshqaradi. U pod'lar qayerda ishlashini, container'larni qayta ishga tushirish kerak yoki kerak emasligini va scaling qanday amalga oshirilishini hal qiladi. Production'da u single point of failure'ning oldini olish uchun bir nechta mashinada ishlaydi va availability zone'lar bo'ylab tarqatiladi.
-
Worker node'lar haqiqiy ilova workload'larini ishga tushiradi. Ilovani deploy qilganingizda, u pod'larga paketlanadi va worker node'larga schedule qilinadi.
Kubernetes'da service nima?
Pod'lar bir martalik. Ular o'chirilib, boshqasi bilan almashtirilganda ularning ichki IP address'lari o'zgaradi. Service bu muammoni o'zgarib turadigan o'sha pod'larga yo'naltiriladigan barqaror kirish nuqtasini taqdim etish orqali hal qiladi va ilovaga doim murojaat qilish mumkin bo'lib qoladi.
Kubernetes service turlari:
-
ClusterIP: cluster ichidan murojaat qilish mumkin bo'lgan barqaror cluster IP address'ini tayinlaydi. Bu standart tur bo'lib, pod-to-pod aloqasi uchun ishlatiladi.
-
NodePort: har bir node'ning IP address'ida statik port ochadi. U cluster tashqarisidan service'ga murojaat qilish imkonini beradi.
-
LoadBalancer: service'ni cloud provider'ingizning tashqi load balancer'i yordamida expose qiladi. NodePort ustiga quriladi.
-
ExternalName: service'ni tashqi DNS nomiga moslaydi va traffic'ni cluster tashqarisidagi service'ga yo'naltiradi.
Kubernetes'da Namespace nima?
Namespace'lar bitta fizik cluster ichida bir nechta virtual cluster yaratish imkonini beradi. Turli jamoalar bir-biriga xalaqit bermasdan o'z bo'limiga ega bo'ladi. Resource nomlari faqat bitta namespace ichida noyob bo'lishi kerak, shuning uchun jamoalar o'rtasidagi nom to'qnashuvlari muammo bo'lmaydi. Resurslardan foydalanishni nazoratda ushlab turish uchun namespace'ga quota'lar, access control'lar va policy'lar biriktirishingiz mumkin.
Docker va Kubernetes o'rtasidagi farq nima?
Docker — container'larni build qilish va ishga tushirish uchun platforma. U ilovangizni va unga kerak bo'lgan hamma narsani lokal noutbukdan tortib CI/CD pipeline'gacha bo'lgan barcha muhitlarda bir xil ishlaydigan container'ga paketlaydi.
Kubernetes — container orchestration platformasi. U container'larni build qilmaydi. U ularni mashinalardan iborat cluster bo'ylab schedule qiladi va boshqaradi. Bugungi kunda Kubernetes runtime sifatida Docker'ga tayanmaydi. U Container Runtime Interface orqali containerd yoki CRI-O kabi container runtime'lariga bevosita ulanadi.
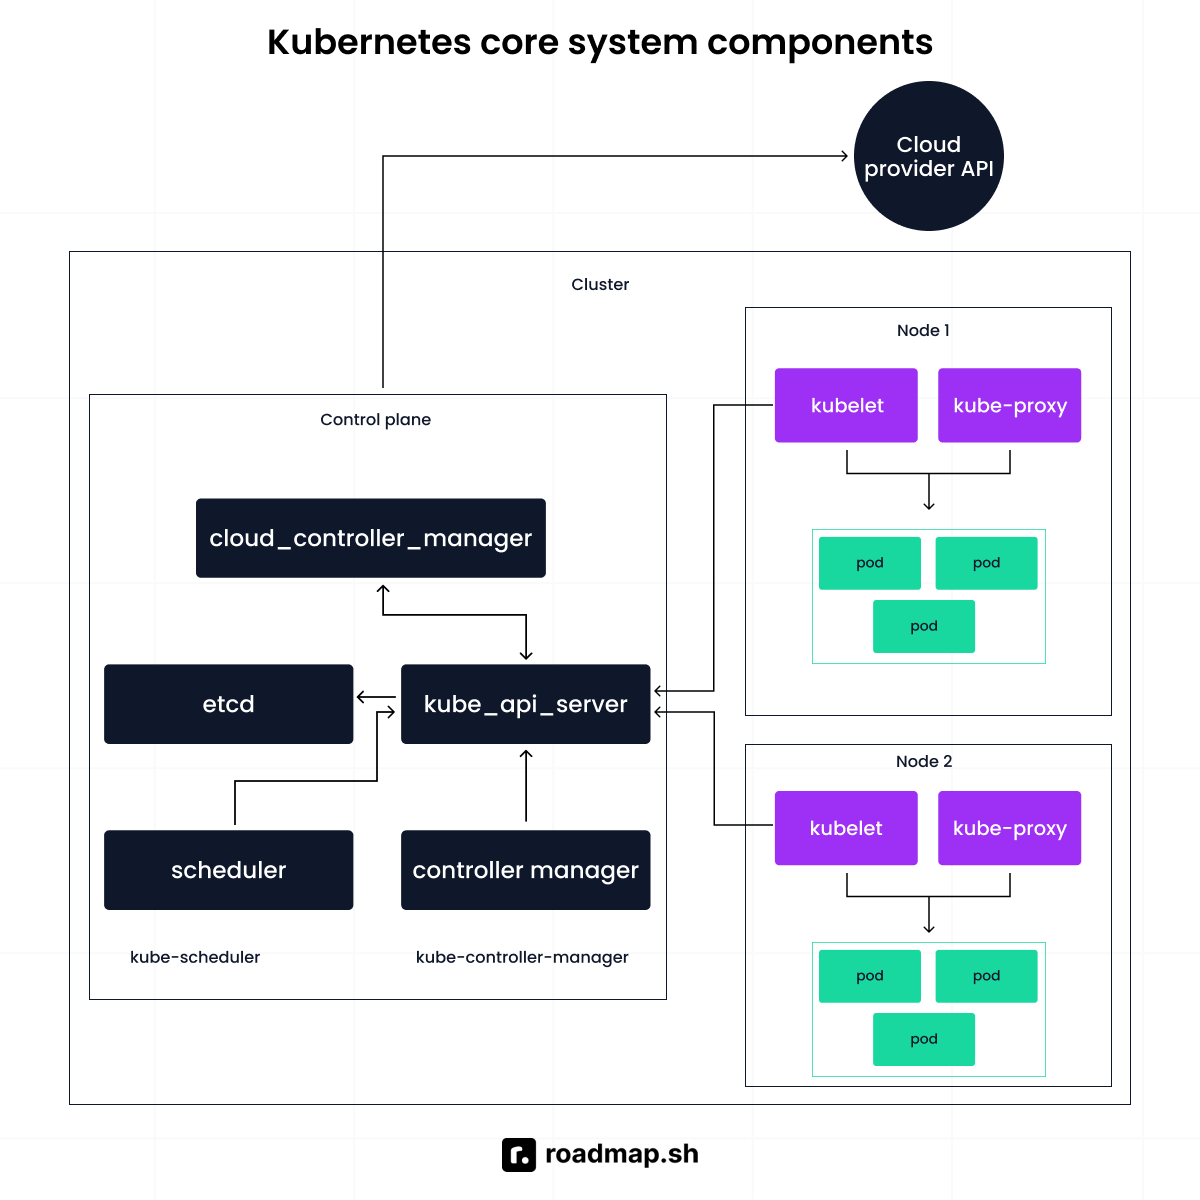
Kubernetes control plane nima?
Kubernetes control plane — cluster'ning miyasi. U API server, scheduler va controller manager'ni o'z ichiga olgan control plane component'lari guruhi sifatida ishlaydi. Production cluster'larida bu component'lar reliability'ni oshirish va single point of failure'ning oldini olish uchun bir nechta node'da ishlaydi. Hamma narsa control plane orqali o'tadi, shuning uchun Kubernetes arxitekturasini tushunish aynan shu yerdan boshlanadi.
Tasavvur qiling, siz onlayn do'konni deploy qilyapsiz. Ilovani container'ga paketlaysiz va uni cluster'ga push qilasiz. Control plane pod'larni worker node'larga schedule qiladi. Agar traffic oshsa, deployment scale qilinadi. Agar node ishdan chiqsa, u workload'ni boshqa node'ga qayta schedule qiladi.
ReplicaSet'ning vazifasini tushuntiring
ReplicaSet — cluster'da bir xil pod replica'larining barqaror soni ishlab turishini ta'minlaydigan Kubernetes controller'i.
Siz kerakli sonni e'lon qilasiz. Shundan boshlab u haqiqiy holatni kuzatib boradi. Agar bitta pod crash bo'lsa yoki node ishdan chiqsa, sog'lom node'da yangisi yaratiladi. Agar pod'lar belgilanganidan ko'p bo'lsa, ortiqchalari terminate qilinadi.
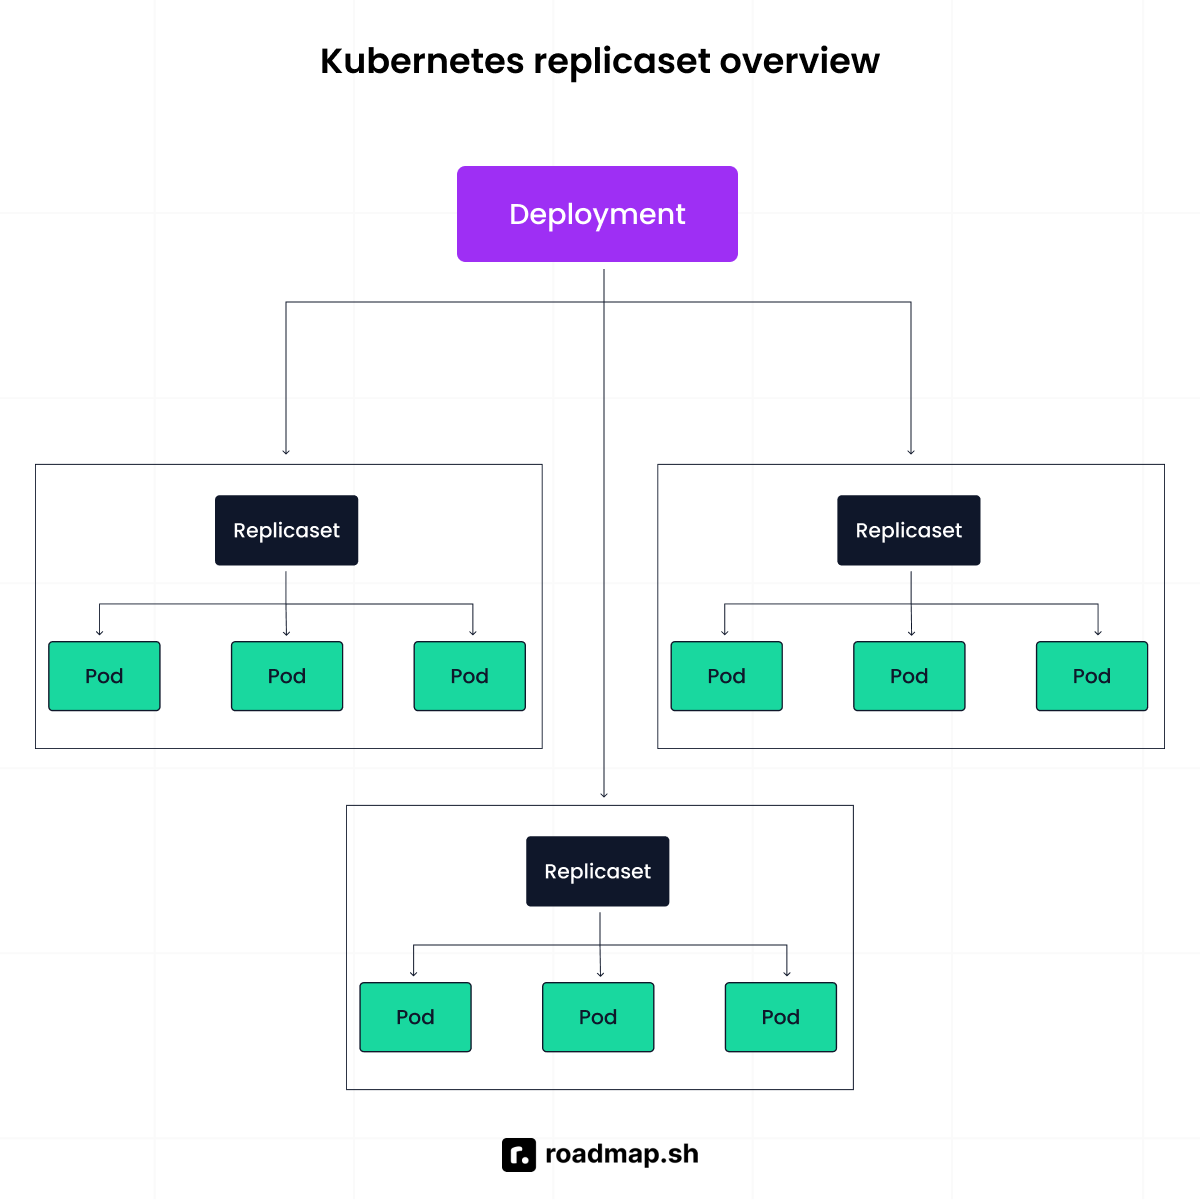
Quyidagi misolda uchta bir xil pod'ni saqlab turish uchun mo'ljallangan ReplicaSet ko'rsatilgan:
apiVersion: apps/v1
kind: ReplicaSet
metadata:
 name: frontend-replicaset
spec:
 replicas: 3  #  number of identical Pods
 selector:
   matchLabels:
     app: frontend
 template:
   metadata:
     labels:
       app: frontend
   spec:
     containers:
     - name: frontend-container
       image: nginx
Kubernetes'da rolling update qanday amalga oshiriladi?
Rolling update backend yangilanayotgan paytda ilovangizning javob berishda davom etishini ta'minlaydi. Bunda hamma narsa birdaniga o'chirib qo'yilmaydi.
U quyidagicha ishlaydi:
-
Kubernetes ilovaning yangilangan versiyasi bilan yangi pod yaratadi.
-
U o'sha pod readiness check'dan o'tishini kutadi.
-
Yangi pod sog'lom holatga kelgach, eski pod terminate qilinadi.
Bu jarayon barcha pod'lar yangi versiyada ishlay boshlaguncha takrorlanadi.
Kubernetes deployment yaratilganda nima sodir bo'ladi?
Kubernetes deployment yaratganingizda, siz Kubernetes'ga desired state'ni aytasiz: nechta replica ishga tushirish kerak, qaysi container image'dan foydalanish kerak va har bir pod'ga qancha resurs kerak. Kubernetes bu holatni cluster'ingizdagi Kubernetes node'lari bo'ylab amalga oshirish uchun ishlaydi.
Sahna ortida Deployment haqiqiy pod'larni boshqaradigan ReplicaSet yaratadi. Agar pod crash bo'lsa yoki node ishdan chiqsa, ReplicaSet uning o'rnini bosuvchi pod'ni avtomatik ravishda yaratadi.
Vaqt o'tishi bilan o'sib boradigan traffic uchun horizontal pod autoscaler (HPA) sozlang. U resurslardan foydalanishga qarab pod'lar sonini moslaydi, shuning uchun ilovangiz qo'lda sozlashsiz ham talabga bardosh beradi.
Kubectl buyrug'ini ishga tushirganingizda nima sodir bo'ladi?
Kubectl qaysi cluster bilan bog'lanish kerakligini aniqlash uchun kubeconfig faylini o'qiydi. So'ngra so'rov API server'ga yuboriladi. API server sizni authenticate qiladi, RBAC orqali permission'laringizni tekshiradi va keyin so'rovni qayta ishlaydi. Agar so'rov cluster holatini o'zgartirsa, API server bu o'zgarishni etcd'da saqlaydi.
Nima uchun Kubernetes'dagi har bir so'rov API server orqali o'tadi?
Kubernetes shunday tuzilganki, barcha aloqa markaziy nuqta bo'lgan API orqali amalga oshadi. So'rov kubectl'danmi, scheduler'danmi yoki boshqa biror component'danmi — barcha so'rovlar u orqali o'tishi shart.
Tasavvur qiling, component'lar cluster ma'lumotlarini validation'siz to'g'ridan-to'g'ri yangilay olsa. Natijada nomuvofiq holatlar va xavfsizlik muammolari yuzaga kelardi. API server har bir so'rovni tekshiradi, permission'larni tasdiqlaydi va keyin yo amalni bajaradi, yo ma'lumot qaytaradi.
Agar API server ishdan chiqsa, mavjud pod'lar ishlashda davom etishi mumkin, lekin siz yangi workload'larni deploy qila olmaysiz.
Kubernetes cluster'ida etcd'ning vazifasini tushuntiring
Etcd — cluster ma'lumotlarini saqlaydigan distributed key-value store. U konfiguratsiya tafsilotlari, metadata va tizim holatini, ya'ni cluster ishlashi uchun kerak bo'lgan hamma narsani saqlaydi.
U fault-tolerant qilib qurilgan. Hatto node ishdan chiqsa yoki network partition yuz bersa ham, etcd quorum-based consensus yordamida data consistency'ni saqlab qoladi. Multi-node control plane sozlamasida bu biror narsa noto'g'ri ketganda cluster holatining ishonchli bo'lib qolishini ta'minlaydi.
Agar etcd buzilsa, cluster ko'r bo'lib qoladi. Control plane nima mavjud bo'lishi kerakligi haqidagi xotirasini yo'qotadi. Shuning uchun production'da etcd backup'lari juda muhim. Faqat API server etcd bilan bevosita aloqa qiladi. Bu ajratish cluster holatining integrity'sini himoya qiladi.
Nima uchun Kubectl kubeconfig faylisiz ishlay olmaydi?
Kubeconfig fayli kubectl o'rnatilgan mashinada joylashadi. Unda cluster endpoint'i va authenticate qilish uchun kerak bo'lgan credential'lar saqlanadi. Kubectl buyrug'ini ishga tushirganingizda, u birinchi navbatda shu faylni o'qiydi. Yaroqli endpoint va credential'larsiz kubectl'ning hech qanday tayanch nuqtasi bo'lmaydi. U qaysi cluster'ga murojaat qilishni ham, shaxsingizni qanday tasdiqlashni ham bilmas edi.
Kubernetes'da DaemonSet nima?
DaemonSet cluster'dagi har bir node'da pod'ning bitta nusxasi ishlashini ta'minlaydi. Yangi node qo'shsangiz, pod avtomatik ravishda unga joylashadi. Node'ni olib tashlasangiz, pod ham u bilan birga ketadi.
Bu uni log yig'ish, monitoring agent'lari yoki network plugin'lari kabi har bir node'da bir xil workload ishlashi kerak bo'lgan node darajasidagi vazifalar uchun foydali qiladi.
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: log-collector
spec:
  selector:
    matchLabels:
      app: log-collector
  template:
    metadata:
      labels:
        app: log-collector
    spec:
      containers:
      - name: log-collector
        image: fluentd
Boshlang'ich savollar Kubernetes qanday qurilganini tushunishingizni tekshiradi. Keyingi, o'rta darajadagi savollar esa u bilan ishlay olishingizni tekshiradi.
O'rta darajadagi Kubernetes intervyu savollari va javoblari
Kubernetes'da scheduling qanday ishlaydi?
Scheduler pod qaysi node'da ishlashi kerakligini hal qiladi. Pod yaratganingizda unga hali hech qanday node tayinlanmagan bo'ladi. Scheduler shu unscheduled holatdagi pod'larni kuzatib boradi va qaror qabul qilishdan oldin barcha node'lardagi mavjud CPU, xotira va cheklovlarni tekshiradi.
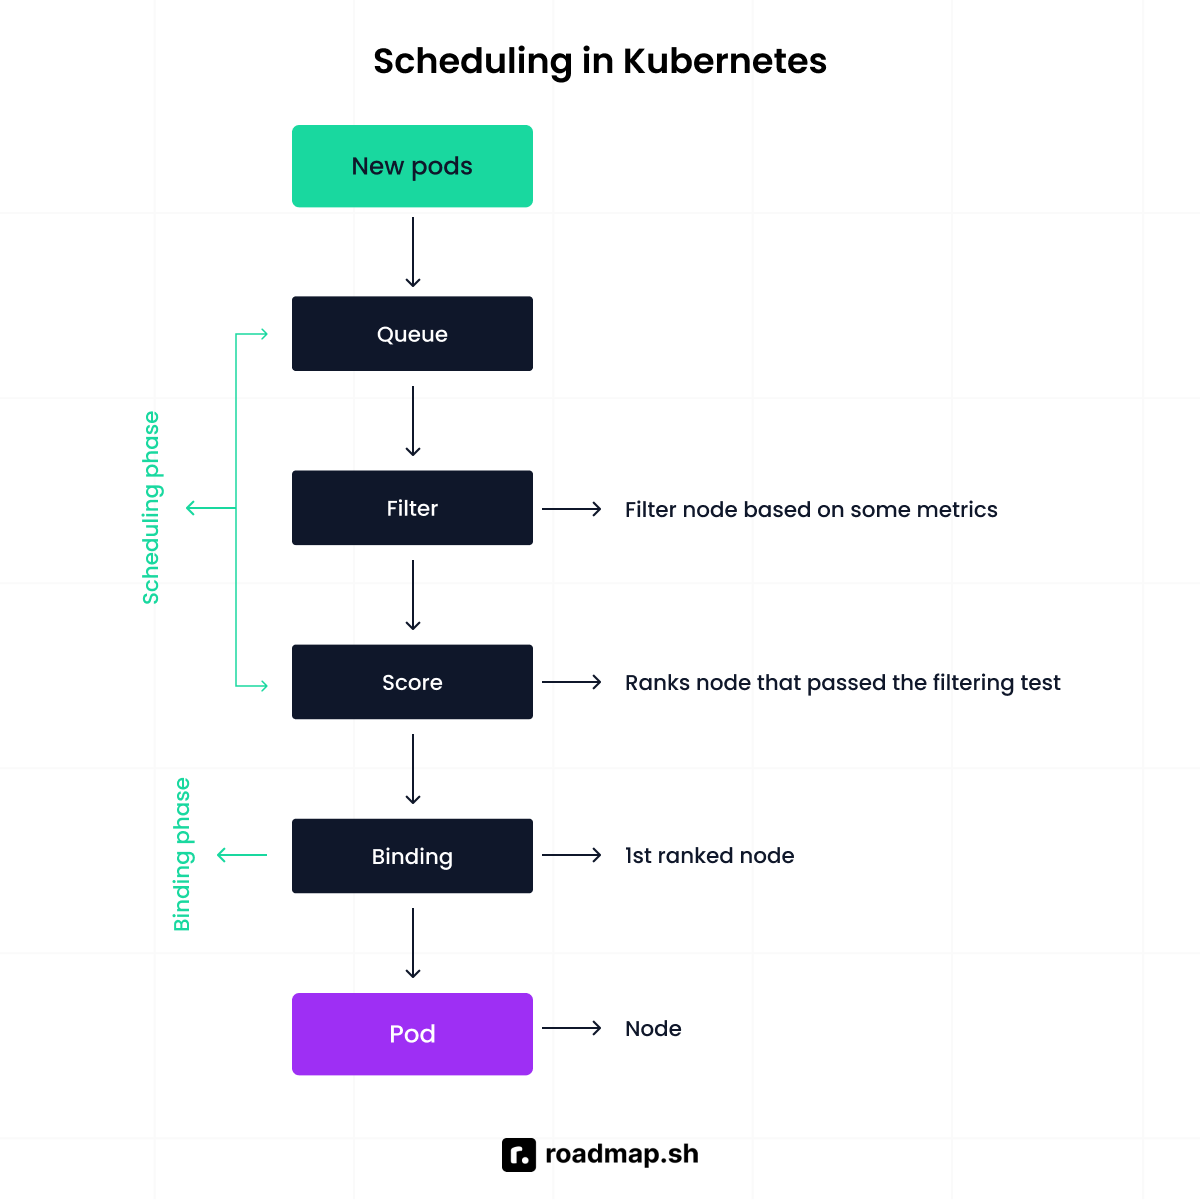
Scheduler mantiqi uch bosqichdan iborat: filtering, scoring va binding.
-
Filtering: pod talablarini qondira olmaydigan har qanday node'ni chiqarib tashlaydi, masalan, CPU yetarli bo'lmasa, node ready holatida bo'lmasa yoki unda noto'g'ri taint bo'lsa.
-
Scoring qolgan node'larni mavjud resurslar, affinity qoidalari va boshqa afzalliklarga qarab reyting bo'yicha tartiblaydi. Pod eng yuqori ball olgan node'ga joylashadi.
-
Binding: API server'ni yangilash orqali pod'ni g'olib node'ga tayinlaydi. O'sha node'dagi kubelet ishni o'z zimmasiga oladi va pod'ni ishga tushiradi.
Deployment va StatefulSet o'rtasidagi farq nima?
Deployment'lar ham, StatefulSet'lar ham pod replica'larini boshqaradi, lekin identity va storage'ga turlicha yondashadi.
Kubernetes deployment veb-sayt frontend'lari va REST API'lar kabi stateless ilovalar uchun eng yaxshi ishlaydi. Pod'larni yaratish yoki yo'q qilish mumkin, chunki hech narsa lokal storage'ga bog'liq emas. Agar biri crash bo'lsa, uning o'rnini boshqasi egallaydi va buni hech kim sezmaydi.
StatefulSet ma'lumotlar bazalari kabi stateful ilovalar uchun mo'ljallangan. Har bir pod noyob identity'ga ega va restart'lardan keyin ham saqlanib qoladigan persistent storage talab qiladi. Agar ma'lumotlar bazasi pod'i qayta yaratilsa, u o'sha nom va o'sha persistent volume'lar bilan qaytadi. Bunday barqarorlik bo'lmasa, ma'lumotlar bazasi o'zining butun ma'lumotlarini yo'qotib qo'yadi.
Quyida Deployment yordamida NGINX veb-serverini ishlatadigan to'rtta pod replica'sini ishga tushiruvchi oddiy manifest keltirilgan:
apiVersion: apps/v1
kind: Deployment
metadata:
 name: web-app
spec:
 replicas: 4
 selector:
   matchLabels:
     app: web-app
 template:
   metadata:
     labels:
       app: web-app
   spec:
     containers:
     - name: web-app
       image: nginx
Mana uchta MySQL replica'sini ishga tushiradigan ekvivalent StatefulSet:
apiVersion: apps/v1
kind: StatefulSet
metadata:
 name: mysql
spec:
 serviceName: "mysql"
 replicas: 3
 selector:
   matchLabels:
     app: mysql
 template:
   metadata:
     labels:
       app: mysql
   spec:
     containers:
     - name: mysql
       image: mysql:8
       volumeMounts:
       - name: mysql-data
         mountPath: /var/lib/mysql
 volumeClaimTemplates:
 - metadata:
     name: mysql-data
   spec:
     accessModes: ["ReadWriteOnce"]
     resources:
       requests:
         storage: 5Gi
Kubernetes scaling'ni qanday amalga oshiradi?
Scaling — talabga qarab ishlayotgan pod'lar sonini moslash. Buni deployment'ingizda replica sonini belgilash orqali qo'lda bajarishingiz mumkin:
apiVersion: apps/v1
kind: Deployment
metadata:
 name: my-product
spec:
 replicas: 7
 selector:
   matchLabels:
     app: my-product
 template:
   metadata:
     labels:
       app: my-product
   spec:
     containers:
     - name: my-product
       image: my-image
Agar bitta pod ishdan chiqsa, deployment controller uning o'rnini bosuvchi pod yaratadi. Ammo dinamik muhitlarda qo'lda scaling qilish amaliy emas. Tasavvur qiling, siz onlayn poyabzal do'konini yuritasiz. Kunduzi traffic oshadi, kechasi esa kamayadi. Pod'larning qat'iy sonini saqlash kechasi resurslarni isrof qiladi va eng yuqori talab paytida crash bo'lish xavfini tug'diradi. Aynan shu yerda Horizontal Pod Autoscaler (HPA) yordamga keladi. U CPU va xotiradan foydalanishga qarab replica sonini avtomatik ravishda moslaydi.
Kubernetes'da networking qanday ishlaydi?
Default holatda Kubernetes cluster'idagi pod'lar bir-biri bilan bevosita aloqa qila oladi. Har bir pod o'zining IP address'ini oladi va Kubernetes networking pod'larga xuddi bitta tarmoqda turgandek node'lar bo'ylab aloqa qilish imkonini beradi. Bu Flannel yoki Weave kabi CNI plugin orqali amalga oshiriladi.
Pod IP'lari vaqtinchalik bo'lib, pod qayta yaratilganda o'zgaradi. Bu muammoni hal qilish uchun Kubernetes Service'lardan foydalanadi: ular barqaror IP address taqdim etadi va traffic'ni pod'lar o'rtasida load balance qiladi.
Ingress Service'lar ustida joylashadi. U tashqi mijozlardan keladigan traffic'ni boshqaradi va so'rovlarni domenlar yoki URL path'lariga qarab to'g'ri service'ga yo'naltiradi; bu qoidalarni amalga oshirish uchun ingress controller'dan foydalanadi.
ConfigMap'lar va Secret'lar nima?
ConfigMap'lar va Secret'lar konfiguratsiya va maxfiy ma'lumotlarni container image'laringizdan tashqarida saqlaydi.
Qiymatlarni ilova kodiga hardcode qilish xavfsizlik xavflarini tug'diradi va codebase'ni qo'llab-quvvatlashni qiyinlashtiradi. Buning o'rniga Kubernetes konfiguratsiyani runtime'da inject qilish imkonini beradi.
ConfigMap URL'lar, port konfiguratsiyalari va environment variable'lar kabi maxfiy bo'lmagan ma'lumotlarni saqlaydi. Secret esa ma'lumotlar bazasi parollari, API key'lar va token'lar uchun mo'ljallangan.
Mana ConfigMap va Secret'ning kod misoli:
apiVersion: v1
kind: Pod
metadata:
  name: my-app
spec:
  containers:
  - name: my-app
    image: nginx
    env:
    - name: API_URL
      valueFrom:
        configMapKeyRef:
          name: my-api-config
          key: API_URL
    - name: APP_COLOR
      valueFrom:
        configMapKeyRef:
          name: my-api-config
          key: APP_COLOR
    - name: PASSWORD
      valueFrom:
        secretKeyRef:
          name: my-api-secret
          key: PASSWORD
Pod o'ziga ajratilgan memory limit'dan oshib ketsa nima bo'ladi?
Linux kernel container'ni out-of-memory (OOM) xatosi bilan terminate qiladi. Memory limit'lar qat'iy qo'llaniladi; throttle qilinishi mumkin bo'lgan CPU'dan farqli o'laroq, xotirani overcommit qilib bo'lmaydi.
Terminate qilingandan so'ng Kubernetes pod'ning restart policy'siga amal qiladi. Deployment'lar uchun u default holatda Always bo'ladi. Agar container o'z memory limit'idan oshib ketsa, pod CrashLoopBackOff holatiga o'tadi.
Agar butun node'da xotira kamayib qolsa, Kubernetes node barqarorligini himoya qilish uchun pod'larni evict qilishi mumkin.
Secret'ni pod'ga qanday mount qilasiz?
Secret'ni volume sifatida mount qilish yoki environment variable sifatida inject qilish mumkin. Volume sifatida mount qilinganda, ilova maxfiy ma'lumotlarni fayl tizimidan o'qiydi.
secretKeyRef yordamida environment variable sifatida ishlatilganda, secret'dagi ma'lum bir key container'dagi o'zgaruvchiga moslanadi. Bu usul ko'pincha ma'lumotlar bazasi parollari yoki API token'lari uchun ishlatiladi.
apiVersion: v1
kind: Pod
metadata:
 name: my-app
spec:
 volumes:
 - name: secret-volume
   secret:
     secretName: my-api-secret
 containers:
 - name: my-app
   image: nginx
   volumeMounts:
   - name: secret-volume
     mountPath: /etc/secrets
     readOnly: true
   env:
   - name: DB_PASSWORD
     valueFrom:
       secretKeyRef:
         name: my-api-secret
         key: PASSWORD
Kubernetes'da proxy'ning vazifasini tushuntiring.
Kube-proxy har bir node'da ishlaydi va service'lar uchun tarmoq aloqasini boshqaradi. U endpoint o'zgarishlarini kuzatish uchun Kubernetes API'ni nazorat qilib boradi va node'ning networking qoidalarini yangilaydi.
Traffic Service'ning virtual IP'siga kelganda, kube-proxy iptables yoki IPVS yordamida routing qoidalarini sozlaydi, shunda kernel bu traffic'ni to'g'ri backend pod'larga yo'naltiradi.
Kubernetes'da readiness va liveness probe'lar qanday ishlaydi?
Probe — kubelet container holatini aniqlash uchun foydalanadigan health check mexanizmi. Uning uch turi bor:
-
Readiness probe: container traffic'ga xizmat ko'rsatishga tayyor yoki tayyor emasligini tekshiradi. Agar u muvaffaqiyatsiz bo'lsa, pod qayta muvaffaqiyatli o'tmaguncha service endpoint'idan olib tashlanadi.
-
Liveness probe: container hali ham tirik yoki tirik emasligini tekshiradi. Agar u muvaffaqiyatsiz bo'lsa, Kubernetes container'ni kill qiladi. Deadlock'lar va cheksiz sikllar kabi muammolarga duch kelganingizda liveness probe'dan foydalanishingiz mumkin.
-
Startup probe: ilova ishga tushishni tugatgan yoki tugatmaganini tekshiradi. Sekin ishga tushadigan, aks holda tayyor bo'lishidan oldin liveness probe tomonidan kill qilinadigan container'lar uchun foydali. U muvaffaqiyatli o'tgach, ishni liveness va readiness probe'lar o'z zimmasiga oladi.
Pod'ning keng tarqalgan uchta nosozlik holati qaysilar va ularni qanday troubleshoot qilasiz?
Pod'lar CrashLoopBackOff, Pending yoki ImagePullBackOff kabi holatlarda qotib qolishi mumkin. Ularni qanday aniqlash va tuzatish mumkinligi quyida keltirilgan.
-
CrashLoopBackOff container doimiy ravishda crash bo'layotganini bildiradi. Kubernetes uni qayta ishga tushiradi, lekin takroriy nosozliklardan so'ng qayta ishga tushirishni tobora kechiktiradi. kubectl logs yordamida log'larni tekshiring va yetishmayotgan environment variable'lar, dependency nosozliklari yoki noto'g'ri startup buyruqlarini qidiring.
-
Pending Kubernetes pod'ni schedule qila olmayotganini bildiradi. Odatda sababi CPU yoki xotira yetishmasligi, PersistentVolume'larning yo'qligi yoki scheduling'ni bloklayotgan taint'lar bo'ladi. Pod nima uchun node'ga tayinlanmaganini aniq ko'rish uchun kubectl describe pod buyrug'ini ishga tushiring.
-
ImagePullBackOff Kubernetes container image'ni pull qila olmayotganini bildiradi. Bunga noto'g'ri image nomi, private registry bilan authentication muammolari yoki tarmoq muammolari sabab bo'ladi. kubectl describe pod buning sababini aytib beradi.
Kubernetes cluster ulanishlarini boshqarish uchun konfiguratsiya fayllaridan qanday foydalanadi?
Kubernetes kubectl kabi client'larning Kubernetes API server'iga qanday ulanishini boshqarish uchun kubeconfig faylidan foydalanadi. Default holatda u ~/.kube/config manzilida joylashadi.
Fayl uchta narsa atrofida qurilgan:
-
Cluster: API server manzilini va cluster'ning haqiqiyligini tekshirish uchun ishlatiladigan certificate authority ma'lumotlarini belgilaydi.
-
Users: authentication credential'larini saqlaydi — token'lar, client certificate'lar yoki qo'llab-quvvatlanadigan boshqa usullar.
-
Context: cluster va user'ni bir-biriga bog'laydi. kubectl config use-context buyrug'ini ishga tushirganingizda, qaysi cluster va credential'lardan foydalanishni tanlaysiz.
apiVersion: v1
kind: Config
current-context: Stage-admin
clusters:
- name: Staging-Cluster
 cluster:
   server: https://api.example.com
users:
- name: admin-user
 user:
   token: BCVWXabcUWQzy
contexts:
- name: Stage-admin
 context:
   cluster: Staging-Cluster
   user: admin-user
Kubernetes'dagi taint'lar va toleration'lar tushunchasini tushuntiring.
Taint'lar va toleration'lar qaysi Pod'lar qaysi node'larda schedule qilinishi mumkinligini nazorat qiladi. Taint pod'larni node'dan itarib turadi. Toleration esa pod'ga taint qo'yilgan node'da schedule qilinishiga ruxsat beradi. Taint'lar Pod'larni bloklaydi; toleration'lar istisnolarga ruxsat beradi.
Taint'larning uchta effekti bor:
1. NoSchedule: taint'ni tolerate qilmaydigan yangi pod'larning bu node'ga schedule qilinishiga yo'l qo'ymaydi.
2. PreferNoSchedule: bu yumshoq qoida; Kubernetes pod'larni u yerga joylashtirmaslikka harakat qiladi, lekin zarur bo'lsa baribir joylashtirishi mumkin.
3. NoExecute: nafaqat scheduling'ning oldini oladi, balki taint'ni tolerate qilmaydigan mavjud pod'larni ham evict qiladi.
Pod'lar o'rtasidagi aloqaga qanday erishish mumkin?
Kubernetes'da pod-to-pod aloqasi cluster networking modeliga tayanadi. Default holatda Kubernetes Container Network Interface (CNI) plugin o'rnatilgan bo'lishini kutadi. Flannel yoki Weave kabi network plugin sozlangach, har bir pod o'z IP address'ini oladi va cluster tarmog'i orqali node'lar bo'ylab aloqa qila oladi.
Kubernetes Pod'larini qanday debug qilasiz?
Pod'ni debug qilish uchun quyidagini ishga tushiring:
kubectl describe pod <pod-name>
Events bo'limi joylashgan eng pastki qismga o'ting. Odatda Kubernetes aynan o'sha yerda nima noto'g'ri ketganini aniq aytadi: image'ni pull qila olmaganmi, pod'ni schedule qila olmaganmi yoki butunlay boshqa narsami.
Agar pod ishlayotgan bo'lsa-yu, lekin baribir g'alati ishlasa, muammo ilovaning o'zida bo'lishi mumkin. Log'larni tekshiring:
kubectl logs <pod-name>
Agar o'sha pod ichida bir nechta container bo'lsa, Kubernetes qaysi biri haqida so'rayotganingizni bilishi kerak:
kubectl logs <pod-name> -c <container-name>
Log'lar container crash bo'lishidan oldin nima qilayotganini ko'rsatadi. Ko'pchilik debugging sessiyalari shu yerda boshlanadi va shu yerda tugaydi.
Kubernetes'da PersistentVolume va PersistentVolumeClaim nima?
PersistentVolume — cluster'da provision qilingan va har qanday pod'dan mustaqil yashaydigan storage resource'i. Bu pod o'chirilganda yoki qayta schedule qilinganda ham ma'lumotlar saqlanib qolishini anglatadi.
apiVersion: v1
kind: PersistentVolume
metadata:
 name: app-pv
spec:
 capacity:
   storage: 5Gi
 accessModes:
   - ReadWriteOnce
 hostPath:
   path: /data/app
PersistentVolumeClaim — pod hajm va access mode'ni ko'rsatib persistent volume'larni so'rash usuli, Kubernetes esa uni mavjud volume'ga moslaydi.
Yuqori darajadagi Kubernetes intervyu savollari va javoblari
Kubernetes high availability'ni qanday ta'minlaydi?
Kubernetes ilovadan tortib control plane'ning o'zigacha bo'lgan har bir qatlamda single point of failure'larni bartaraf etish orqali high availability'ni ta'minlaydi.
Ilova qatlamida siz bir nechta replica ishga tushirasiz. Agar bitta pod crash bo'lsa yoki node ishdan chiqsa, Kubernetes workload'larni sog'lom node'larga qayta schedule qiladi va o'rnini bosuvchi pod'larni yaratadi. Hatto yangilanishlar paytida ham eski versiyalar shunday almashtiriladiki, ilova ishlashda davom etadi.
Control plane qatlamida bir nechta API server load balancer ortida ishlaydi, shuning uchun hech bir instance bottleneck'ga aylanmaydi. Etcd quorum-based consensus'dan foydalanadigan distributed cluster sifatida ishlaydi va a'zolarning ko'pchiligi sog'lom ekan, node nosozliklariga bardosh beradi. Scheduler va controller manager odatda leader election yordamida bir nechta instance'da ishlaydi. Bitta instance leader bo'ladi, qolganlari esa leader ishdan chiqsa, uning o'rnini egallashga tayyor turadi.
Control plane'ni ham, worker node'larni ham bir nechta availability zone bo'ylab tarqatish zone darajasidagi nosozliklardan himoya qiladi.
Kubernetes cluster'ini qanday himoyalaysiz?
Kubernetes xavfsizligi kirishni boshidan oxirigacha nazorat qilishdan boshlanadi. Avval cluster bilan kim ishlay olishini hal qilasiz. Keyin workload'larga nima qilishga ruxsat berilishini. Va nihoyat, o'sha workload'lar tayanadigan ma'lumotlarni himoya qilasiz.
Hammasi API server'dan boshlanadi. Har bir so'rov client certificate'lar, bearer token'lar yoki OIDC yordamida authenticate qilinadi. Authentication'dan so'ng RBAC identity qanday amallarni bajara olishini belgilaydi.
Pod security admission va pod security standards pod'lar runtime'da nima qila olishini belgilaydi, masalan, privileged container'lar yoki root sifatida ishlaydigan container'larning oldini oladi. Network policy'lar pod'larning bir-biri bilan qanday aloqa qilishini cheklab, keraksiz ichki traffic'ni kamaytiradi.
Secret'lar parollar va API key'lar kabi maxfiy ma'lumotlarni saqlaydi. Default holatda ular faqat base64-encode qilingan bo'ladi, shuning uchun etcd ichida encryption at rest yoqilishi shart. Barcha cluster aloqasi TLS orqali amalga oshadi va etcd hech qachon workload'lar yoki foydalanuvchilar uchun bevosita ochiq bo'lmasligi kerak. Faqat kube-apiserver etcd bilan xavfsiz kanal orqali aloqa qilishi kerak. Ko'plab production muhitlari qattiqroq nazorat uchun HashiCorp Vault yoki AWS Secrets Manager kabi tashqi secret manager'larni ham integratsiya qiladi.
Ishdan chiqayotgan pod'ni qanday troubleshoot qilasiz?
Log'lardan boshlang. Ular ilova ishdan chiqishidan oldin nima qilayotganini ko'rsatadi. Agar u qayta-qayta restart bo'layotgan bo'lsa, kubectl logs --previous yordamida oldingi instance'ni tekshiring. Haqiqiy xato ko'pincha crash'dan sal oldin paydo bo'ladi.
Keyin kubectl describe pod yordamida event'larni ko'zdan kechiring. Log'lar ilova chiqishini ko'rsatadi. Event'lar esa Kubernetes nima qilganini yoki nima qila olmaganini ko'rsatadi, masalan, image pull xatolari, muvaffaqiyatsiz probe'lar yoki volume mount muammolari. Pod status'ini tekshiring. Pending scheduling yoki resurs cheklovlariga ishora qiladi. CrashLoopBackOff container startup paytida doimiy ravishda ishdan chiqayotganini bildiradi. Bu bosqichda resource request'lar, environment variable'lar va tashqi dependency'larni tekshiring.
Agar hech narsa ko'zga tashlanmasa, node darajasiga o'ting. Pod schedule qilingan node'dagi kubelet log'larini tekshiring. systemd'ga asoslangan tizimlarda journalctl -u kubelet buyrug'idan foydalaning.
Agar muammo kubelet'da bo'lmasa, container runtime log'larini ko'zdan kechiring. containerd yoki CRI-O kubectl orqali hech qachon ko'rinmaydigan quyi darajadagi xatolarni ko'rsatib berishi mumkin.
Kubernetes rolling update'lar va rollback'larni qanday boshqaradi?
Kubernetes rolling update'larni versiyalangan ReplicaSet'larni boshqaradigan Deployment'lar orqali amalga oshiradi. Pod template o'zgarganda, Kubernetes yangi ReplicaSet yaratadi va eskisini asta-sekin scale down qiladi.
Default strategiya — RollingUpdate, u ikkita parametr bilan boshqariladi. maxUnavailable yangilanish paytida nechta pod mavjud bo'lmasligi mumkinligini belgilaydi. maxSurge kerakli replica sonidan ortiq nechta qo'shimcha pod yaratilishi mumkinligini belgilaydi. Ular birgalikda rollout tezligini muvozanatlaydi.
Jarayonni kubectl rollout status yordamida kuzating. Agar biror narsa noto'g'ri ketsa, kubectl rollout undo oxirgi barqaror holatni darhol tiklaydi.
Kubernetes rollback uchun eski ReplicaSet'larni revisionHistoryLimit field'i yordamida saqlab qoladi. Default qiymat — 10. Resurslarni tejash uchun uni kamaytiring. Keyinchalik ko'proq rollback imkoniyatlariga ega bo'lishni istasangiz, uni oshiring.
Kubernetes cluster'larini qanday monitoring qilasiz va kuzatasiz?
Monitoring uchta narsadan xabardor bo'lib turishni anglatadi: tizim qanday ishlayapti, u nima qilib kelgan va qachon biror narsa e'tiboringizni talab qiladi.
Prometheus — metric'larni yig'ish uchun asosiy tanlov. U cluster component'lari, node'lar va ilovalaringizdan ma'lumotlarni scrape qiladi. Kubernetes obyektlarining holatini, ya'ni replica sonlari, pod phase'lari va resource request'lar kabi narsalarni ko'rish uchun kube-state-metrics qo'shing. Grafana bu metric'larni haqiqatan ham o'qish mumkin bo'lgan dashboard'larga aylantiradi.
Raqamlar g'alati ko'rinsa, log'lar nima sodir bo'lganini aytib beradi. Agar pod qayta-qayta restart bo'layotgan bo'lsa, log'lar buning sababi muvaffaqiyatsiz ulanishmi, yetishmayotgan config'mi yoki exception'mi ekanini ko'rsatadi. Fluentd, Loki yoki ELK stack bu log'larni markazlashtiradi, shunda siz node'lar orasida sakrab yurmaysiz.
Alerting hamma narsani bir-biriga bog'laydi. Siz Prometheus Alertmanager'da threshold'larni belgilaysiz va biror narsa chegaradan oshganda sizga xabar keladi va siz uni tuzatasiz.
2026-yilda albatta kerak bo'ladigan 15 ta DevOps monitoring vositasi bilan tanishish uchun maxsus qo'llanmamizni ko'rib chiqing.
Kubernetes resurslarni boshqarish va limit'larni qanday amalga oshiradi?
Kubernetes request'lar va limit'lar orqali ilovangizga nima kerakligini va u qancha ishlata olishini belgilash imkonini beradi.
Request'lar talab qilinadigan minimal CPU va xotirani belgilaydi. Scheduler pod qayerda ishlashini hal qilish uchun ulardan foydalanadi. Agar node resurslar cheklanganligi sababli so'ralgan resurslarni ta'minlay olmasa, pod u yerga schedule qilinmaydi.
Container ishga tushgach, limit'lar kuchga kiradi. Kubernetes resurslarini shu darajada boshqarish muhim, chunki CPU limit'idan oshish container'ni throttle qiladi. Memory limit'idan oshish esa uni out-of-memory kill bilan terminate qiladi. Resurslardan foydalanishni kuzatib borish bu muammolarni foydalanuvchilaringizga ta'sir qilishidan oldin aniqlashga yordam beradi.
Kubernetes cluster'ini qanday xavfsiz upgrade qilasiz?
Kubernetes cluster'ini upgrade qilish asosan ketma-ketlik va moslikka bog'liq. Avval control plane'ni upgrade qilasiz, bu esa uning asosiy component'larini upgrade qilishni anglatadi: API server, controller manager, cloud controller manager va scheduler. Worker node'lar control plane versiyasidan orqada bo'lishi mumkin, lekin hech qachon undan oldinda bo'lmasligi kerak.
Shundan so'ng cluster node'larini birma-bir upgrade qilasiz. Upgrade qilishdan oldin har bir node'ni cordon va drain qiling, shunda workload'lar boshqa node'larga xavfsiz ko'chadi, keyin node'ni qayta ishga tushirib, davom eting. Bu uzilishlarni kamaytiradi.
Downtime'ni minimallashtirish uchun versiya o'zgarishlarini ko'rib chiqing, cluster ma'lumotlarining backup'ini oling, oldindan test qiling va ilovalaringiz ishlashda davom etishi uchun yetarli replica'larga ega ekanini ta'minlang.
Kubernetes'dagi PodDisruptionBudget (PDB) tushunchasini tushuntiring.
PodDisruptionBudget node upgrade'lari yoki texnik xizmat ko'rsatish kabi rejalashtirilgan cluster ishlari paytida ilovangizni barqaror saqlaydi. Service maqbul darajadan pastga tushib ketmasligi uchun nechta pod ishlab turishi shartligini belgilaysiz.
Agar bir vaqtning o'zida faqat bitta pod mavjud bo'lmasligi mumkin degan qoida o'rnatsangiz, Kubernetes node drain paytida bunga amal qiladi va budget ruxsat berganidan ko'proq pod'ni evict qilmaydi.
PDB'lar faqat voluntary disruption'larga taalluqli. Agar node crash bo'lsa, budget sizni himoya qilmaydi. Ular node draining kabi operatsiyalar paytida ishlatiladigan eviction API orqali ishlaydi. Replica'larni kamaytiradigan oddiy scaling o'zgarishlari standart pod termination'ni ishga tushiradi va budget'ga bo'ysunmaydi.
Kubernetes'dagi CRD'lar tushunchasini tushuntiring?
Kubernetes custom resource definition o'zingizning resource turlaringizni yaratish orqali Kubernetes'ni kengaytirish imkonini beradi. Pod'lar yoki deployment'lar kabi built-in obyektlar bilan cheklanib qolish o'rniga, ehtiyojlaringizga mos keladigan yangi narsani belgilaysiz.
Bu Kubernetes operator'ining asosi. Operator custom resource'ni belgilash uchun CRD'dan foydalanadi, keyin uni kuzatib boradi va xuddi Kubernetes o'z resource'larini boshqargani kabi unga nisbatan avtomatik ravishda harakat qiladi.
Buni Kubernetes'ga yangi so'z o'rgatish deb tasavvur qiling. Uni belgilaganingizdan so'ng, Kubernetes unga boshqa har qanday resource kabi munosabatda bo'ladi; siz uni xuddi o'sha API va vositalar yordamida yaratishingiz, yangilashingiz, kuzatishingiz va boshqarishingiz mumkin.
Traffic'i oshgan ilovani qanday scale qilasiz?
Traffic oshganda pod'laringizni scale qiling. Replica sonini moslang yoki bu ishni Horizontal Pod Autoscaler'ga topshiring. HPA metrics API orqali CPU va xotiradan foydalanishni kuzatadi va ko'rganiga qarab pod'larni scale up yoki scale down qiladi.
Ko'proq nazorat uchun HPA'ga request rate, queue depth kabi custom metric'larni uzatishda Prometheus adapter'dan foydalaning. Aynan shu yerda autoscaling production'da foydali bo'ladi. Agar node'larda sig'im tugab qolayotgan bo'lsa, Cluster Autoscaler ishga kirishadi. U unscheduled pod'larni aniqlaydi va yangi node'larni provision qiladi. Talab kamayganda, ularni qaytadan scale down qiladi.
Event-driven workload'lar uchun KEDA Kubernetes autoscaling'ini message queue depth, ma'lumotlar bazasidagi satrlar soni yoki HTTP traffic kabi trigger'larni qo'llab-quvvatlaydigan qilib kengaytiradi va bu sizga yolg'iz HPA'dan ko'ra ko'proq ustunlik beradi.
Etcd outage'i yuz berganda nima sodir bo'lishi mumkinligini qisqacha tushuntiring.
Agar etcd ishdan chiqsa, Kubernetes o'z xotirasini yo'qotadi. Etcd butun cluster holatini saqlaydi. Usiz control plane resource'larni yarata, yangilay yoki boshqara olmaydi.
Ishlayotgan pod'lar bir muddat ishlashda davom etishi mumkin, lekin hech qanday o'zgarish kiritib bo'lmaydi. Agar outage uzoq davom etsa yoki ma'lumotlar backup'siz yo'qolsa, tiklash qiyin bo'lishi mumkin. Shuning uchun production'da etcd'ni himoya qilish va uning backup'ini olish juda muhim.
Tashkilot Kubernetes yordamida texnik operatsiyalari samaradorligini qanday oshirishi va xarajatlarni past darajada ushlab turishi mumkin?
Kubernetes workload'larga alohida serverlarda ishlash o'rniga infratuzilmani birgalikda ishlatish imkonini berib, xarajatlarni kamaytiradi. Resource request'lar, limit'lar va autoscaling'ni sozlash orqali ilovalar faqat o'zlariga kerak bo'lgan narsadan foydalanadi va traffic o'zgarishi bilan moslashadi. Built-in avtomatlashtirish deployment'lar va tiklanishni qo'lda aralashuvsiz boshqaradi.
Tashkilotga Kubernetes yordamida deployment strategiyasini o'zgartirish va yanada scalable platforma qurishda qanday yordam bergan bo'lardingiz?
Qo'lda bajariladigan release'lardan Deployment'lar boshqaradigan containerized ilovalarga o'tishdan boshlang. Bu izchillik olib keladi va yangilanishlarni oldindan aytib bo'ladigan qiladi. CI/CD, rolling update'lar va health check'larni joriy qiling. Platforma o'sishni qo'lda aralashuvsiz uddalashi uchun resource limit'lar va autoscaling qo'shing. Uni monitoring va access control'lar bilan mustahkamlang. Va nihoyat, biznes bilan birga scale bo'ladigan tizimga ega bo'ling.
Kubernetes container monitoring uchun qaysi vositalardan foydalanadi?
Kubernetes metric'larni yig'adigan, log'larni to'playdigan va cluster salomatligini kuzatadigan vositalar bilan integratsiya qilinadi. U CPU, xotira va workload unumdorligini o'lchash uchun Prometheus kabi metric vositalari bilan integratsiya qilinadi, Grafana kabi dashboard'lar esa bu ma'lumotlarni vizuallashtirishga yordam beradi. Logging uchun ilova va tizim log'larini yig'ish va markazlashtirishda Fluentd, Elasticsearch yoki Loki kabi vositalardan foydalaniladi.
Ilovani host'ga deploy qilish ilovani container'da deploy qilishdan qanday farq qiladi?
Ilovani to'g'ridan-to'g'ri host'ga deploy qilganingizda, ilova o'sha serverning sozlamalariga bog'liq bo'ladi. Agar serverlar alohida-alohida sozlangan bo'lsa, ilova turlicha ishlashi mumkin. Scaling qo'shimcha serverlarni provision qilish va sozlashni anglatadi.
Container deployment'da ilova va uning dependency'lari bitta birlikka paketlanadi. U hamma joyda bir xil ishlaydi. Scaling ko'proq server qurishni emas, ko'proq container ishga tushirishni anglatadi.
“Immutable infrastructure” tushunchasini va uning Kubernetes'da ilovalarni deploy qilish hamda boshqarish bilan qanday bog'liqligini tushuntiring.
Immutable infrastructure tizimlar deploy qilingandan keyin ularni o'zgartirmaslikni anglatadi. Ishlayotgan serverni yangilash yoki patch qilish o'rniga, siz yangi versiya yaratasiz va eskisini u bilan almashtirasiz.
Kubernetes shu g'oyaga amal qiladi. Ilovani yangilaganingizda, u yangilangan versiya bilan yangi pod'lar yaratadi va eskilarini bosqichma-bosqich almashtiradi. Agar biror narsa noto'g'ri ketsa, rollback qilasiz.
Kubernetes'da RBAC yordamida fine-grained access control'ni qanday amalga oshirasiz?
Role-based access control (RBAC) cluster'ingiz ichida kim nima qila olishini nazorat qiladi. Permission'larni Role yoki ClusterRole orqali belgilaysiz, so'ngra uni RoleBinding yoki ClusterRoleBinding yordamida user, group yoki service account'ga biriktirasiz.
Role bitta namespace ichida ishlaydi. ClusterRole butun cluster'ni qamrab oladi. Qaysi biri mos kelishini hal qilganingizdan so'ng, permission'larni yozing va ularni kirish huquqi kerak bo'lgan har kimga bog'lang.
Avval Role'ni belgilang:
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
 namespace: production
 name: deployer-role
rules:
- apiGroups: ["apps"]
 resources: ["deployments"]
 verbs: ["get", "list", "update", "patch"]
- apiGroups: [""]
 resources: ["pods"]
 verbs: ["get", "list"]
Keyin uni RoleBinding yordamida bog'lang:
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
 name: deployer-binding
 namespace: production
subjects:
- kind: ServiceAccount
 name: ci-service-account
 namespace: production
roleRef:
 kind: Role
 name: deployer-role
 apiGroup: rbac.authorization.k8s.io
Kubernetes multi-tenancy'ni qanday boshqaradi va qanday xavflar mavjud?
Multi-tenancy bir nechta jamoaning bitta cluster'ni birgalikda ishlatishini anglatadi. Namespace'lar mantiqiy ajratishni ta'minlaydi, lekin ular bir jamoaning hammaga tegishli resurslarni iste'mol qilib qo'yishining oldini olmaydi.
ResourceQuota'lar namespace ishlata oladigan resurslarga qat'iy chegara qo'yish orqali buni hal qiladi. Siz CPU, xotira va pod soni uchun yuqori chegarani belgilaysiz va Kubernetes unga rioya qilinishini ta'minlaydi.
Ko'pincha e'tibordan chetda qoladigan xavf kernel darajasida. Bitta node'dagi container'lar host kernel'ini birgalikda ishlatadi, shuning uchun container escape vulnerability'si qo'shni tenant'larga ta'sir qilishi mumkin. Kuchliroq isolation talab qiladigan workload'lar uchun jamoalar alohida node pool'lar yoki gVisor kabi sandboxed runtime'lar, RBAC va network policy'lardan foydalanadi.
Kubernetes'da admission controller'larning vazifasi nima?
So'rov Kubernetes API'ga yetib kelganda, u to'g'ridan-to'g'ri etcd'ga bormaydi. U avval admission controller'lardan o'tadi. Bu plugin'lar biror narsa saqlanishidan oldin so'rovni tekshiradi va konfiguratsiyangizga qarab uni tasdiqlashi yoki bloklashi mumkin.
Ulardan ikkitasi alohida ajralib turadi: MutatingAdmissionWebhook so'rov saqlanishidan oldin uni o'zgartirishi mumkin, ValidatingAdmissionWebhook esa qoidalaringiz asosida uni qabul qilishi yoki rad etishi mumkin.
Aynan shu yerda Kyverno yoki OPA Gatekeeper kabi policy vositalari ishga tushadi. Siz policy yozasiz, uni webhook orqali ulaysiz va har bir so'rov avtomatik ravishda undan o'tadi. Masalan, container'larning root sifatida ishlashini to'xtatmoqchi bo'lsangiz, runAsNonRoot'ni true qilib belgilamagan har qanday pod'ni rad etadigan policy yozasiz.
apiVersion: kyverno.io/v1
kind: ClusterPolicy
metadata:
 name: disallow-root-user
spec:
 validationFailureAction: Enforce
 rules:
 - name: check-runAsNonRoot
   match:
     any:
     - resources:
         kinds:
         - Pod
   validate:
     message: "Containers must not run as root."
     pattern:
       spec:
         containers:
         - securityContext:
             runAsNonRoot: true
Bu qoidani buzgan har qanday pod API darajasida rad etiladi.
Disaster recovery uchun Kubernetes cluster'ini qanday loyihalaysiz?
Etcd butun cluster holatini saqlaydi, shuning uchun birinchi navbatda uni himoya qilish kerak. Buni muntazam snapshot'lar olib, ularni cluster tashqarisida saqlash orqali amalga oshirasiz.
ETCDCTL_API=3 etcdctl snapshot save /backup/etcd-snapshot.db \
 --endpoints=https://127.0.0.1:2379 \
 --cacert=/etc/kubernetes/pki/etcd/ca.crt \
 --cert=/etc/kubernetes/pki/etcd/server.crt \
 --key=/etc/kubernetes/pki/etcd/server.key
Etcd'dan tashqari, control plane va worker node'laringizni bir nechta availability zone bo'ylab tarqating, shunda bitta nosozlik hamma narsani ishdan chiqarmaydi. Kengroq tiklash imkoniyati uchun resource definition'lar va persistent volume ma'lumotlarining backup'ini jadval bo'yicha oling.
Yakuniy fikrlar
Kubernetes intervyulari nimani bilishingizdan ko'ra, bilganingizni qanchalik yaxshi qo'llay olishingiz haqida. Ushbu boshlang'ich, o'rta va yuqori darajadagi savollarni ishlab chiqish intervyu oluvchi sizga real hayotiy ssenariy tashlaganda kerak bo'ladigan mental modelni shakllantirishga yordam beradi. Agar ushbu qo'llanmadagi har bir savolni ishlab chiqqan bo'lsangiz, siz allaqachon ko'pchilik nomzodlardan oldindasiz.
Sizni qiynagan tushunchalarni qayta ko'rib chiqing va ular real hayotda qanday qo'llanishi haqida o'ylab ko'ring. Bu intervyu oluvchidan oldin bo'shliqlarni topishning eng tez yo'li.
Agar keyin nimani o'rganish bo'yicha tuzilgan yo'l kerak bo'lsa, Kubernetes roadmap'i boshlash uchun yaxshi joy. Shuningdek, AI Tutor yordamida mock intervyular o'tkazishingiz va murakkab tushunchalar bo'yicha yechimlar olishingiz mumkin.