Automated regression testing: 2026-yil uchun to'liq qo'llanma
Xatolarni foydalanuvchilardan oldin toping: Playwright, Pytest, Cypress va Selenium yordamida qatlamli regression test suite yarating. Bepul, bosqichma-bosqich qo'llanma.
Muallif: William Imoh
Ilovangiz ustida ishlab, ajoyib kun o'tkazyapsiz, zararsizdek tuyulgan bir o'zgarish kiritasiz va to'satdan ilovaning mutlaqo aloqasi yo'q boshqa qismi ishlamay qoladi. Hech kim authentication flow'ga ham, checkout sahifasiga ham tegmagan, lekin endi ulardan biri buzilgan. Jamoada ishlaganingizda esa vaziyat yanada murakkablashadi. Turli dasturchilar va AI engineer'lar har kuni bitta codebase'ga o'zgarishlar kiritadi va deploy qilishdan oldin mavjud har bir feature'ni qayta test qilishning real imkoni yo'q.
Automated regression testing aynan shu muammoni hal qilish uchun yaratilgan. Har bir bug fix, yangi feature, dependency yangilanishi yoki refactoring'dan keyin ilovangizni qo'lda qayta test qilish o'rniga, u kodingizni yangilaganingiz sayin regression test suite'ni qayta ishga tushiradi va kecha ishlagan funksionallik bugun ham ishlayotganini tekshiradi.
Ushbu qo'llanmada automated regression testing nima ekanini hamda Playwright, Pytest, GitHub Actions, MLflow va Langfuse kabi vositalar workflow'ning turli qismlarini qanday qo'llab-quvvatlashini bilib olasiz. Shuningdek, xuddi shu regression testing tamoyillari LLM ilovalarida qanday qo'llanilishini ko'rasiz — u yerda regression'lar buzilgan funksionallik sifatida emas, balki sifatning pasayishi sifatida namoyon bo'ladi.
Automated regression testing nima?
Agar xatoni tuzatganingizdan, yangi feature qo'shganingizdan yoki ilovangizning biror qismini refactoring qilganingizdan keyin biror feature ishlamay qolsa, siz regression kiritgan bo'lasiz.
Regression testing — kodga o'zgarish kiritilgandan keyin mavjud funksionallik hamon kutilganidek ishlayotganini tekshirish jarayoni. Uning maqsadi — kutilmagan nojo'ya ta'sirlarni ular production'ga yetib bormasidan oldin aniqlash. Buni qo'lda yoki avtomatlashtirish orqali bajarish mumkin.
Qo'lda bajariladigan regression testing'da QA engineer har bir muhim o'zgarishdan keyin oldindan belgilangan test case'larni qo'lda bajarishi kerak. Automated regression testing esa testing framework yordamida xuddi shu test case'larni inson aralashuvisiz — har bir commit'dan keyin, pull request jarayonida, deploy qilishdan oldin yoki CI/CD pipeline'ning boshqa bosqichlarida — dasturiy tarzda bajaradi.
Bu testlarni ishga tushirishdan oldin ular nimani tekshirishini belgilab olishingiz kerak. Regression test suite — bu ishlashi allaqachon tasdiqlangan xatti-harakatni ifodalovchi test case'lar to'plami. Suite'ni ishga tushirasiz va u bu xatti-harakat hamon saqlanib qolganini tekshiradi. O'tgan hafta muvaffaqiyatli o'tgan, bugun esa muvaffaqiyatsiz tugagan test sizga nimadir aytmoqda: ehtimol, yaqinda kiritilgan o'zgarish uni buzgan.
Uchta keng tarqalgan regression testing strategiyasi mavjud:
-
Full retesting: Har bir o'zgarishdan keyin regression test suite'dagi barcha testlarni ishga tushiradi. Har bir test ishga tushgani uchun u boshqa hech narsa buzilmaganiga eng yuqori ishonchni beradi. Kamchiligi shundaki, bu bajarish uchun eng sekin va eng qimmat strategiya, shuning uchun jamoalar odatda uni yirik release'lar yoki ta'siri to'liq tushunilmagan o'zgarishlar uchun saqlab qo'yadi.
-
Test selection: Butun suite'ni ishga tushirish o'rniga, test selection faqat siz o'zgartirgan kod ta'sir qilgan testlarni nishonga oladi. O'zgarishingizga hech qanday aloqasi bo'lmagan testlarni kutib o'tirmaganingiz uchun natijalarni ancha tezroq olasiz. Qiyin tomoni — aynan qaysi testlar ta'sirlanganini bilish; bu odatda tooling'ga sarmoya kiritishni yoki dependency'larni qo'lda kuzatib borish mumkin bo'ladigan darajada test suite'ingizni tartibli saqlashni anglatadi.
-
Test prioritization: Har bir testning ahamiyati bir xil emas. Test prioritization testlarni biznesga ta'siri, risk va tarixiy failure rate kabi omillar asosida tartiblaydi. Authentication, to'lovlar yoki checkout kabi muhim workflow'lar birinchi bo'lib ishga tushadi, bu esa katta ta'sirli regression'larni suite'ning qolgan qismi tugashidan oldin aniqlash ehtimolini oshiradi.
Regression tushunchasi kod doirasidan tashqariga ham chiqadi. LLM ilovalarida prompt yangilanishi, model versiyasining yangilanishi yoki retrieval konfiguratsiyasidagi o'zgarish regression keltirib chiqarishi mumkin. Ilova hamon HTTP 200 qaytaradi, lekin javobda hallucination'lar, sifati pastroq natija yoki noto'g'ri ma'lumot bo'lishi mumkin. Bu regression'larni qanday aniqlashni ushbu qo'llanmaning keyingi qismida ko'rib chiqamiz.
Automated regression testing'ni joriy etish
Sizda allaqachon regression testlar bo'lishi mumkin, ammo keng tarqalgan xatolardan biri — har bir commit'dan keyin butun suite'ni ishga tushirish. Kichik regression suite bilan bu yaxshi ishlaydi, lekin u kattalashgani sari har bir kod o'zgarishini tekshirish ko'proq vaqt oladi. Yechim — qatlamli test strategiyasini qurish, bunda testlarning turli to'plamlari CI/CD pipeline'ingizning turli bosqichlarida ishga tushadi.
Qatlamli test strategiyasini qurish
Har bir regression testga bir xil munosabatda bo'lish o'rniga, ularni uchta qatlamga ajrating. Har bir qatlam ilovangizning holati haqidagi alohida savolga javob beradi. Nimadir noto'g'ri ekanini eng tez ko'rsatadigan qatlamdan boshlang.
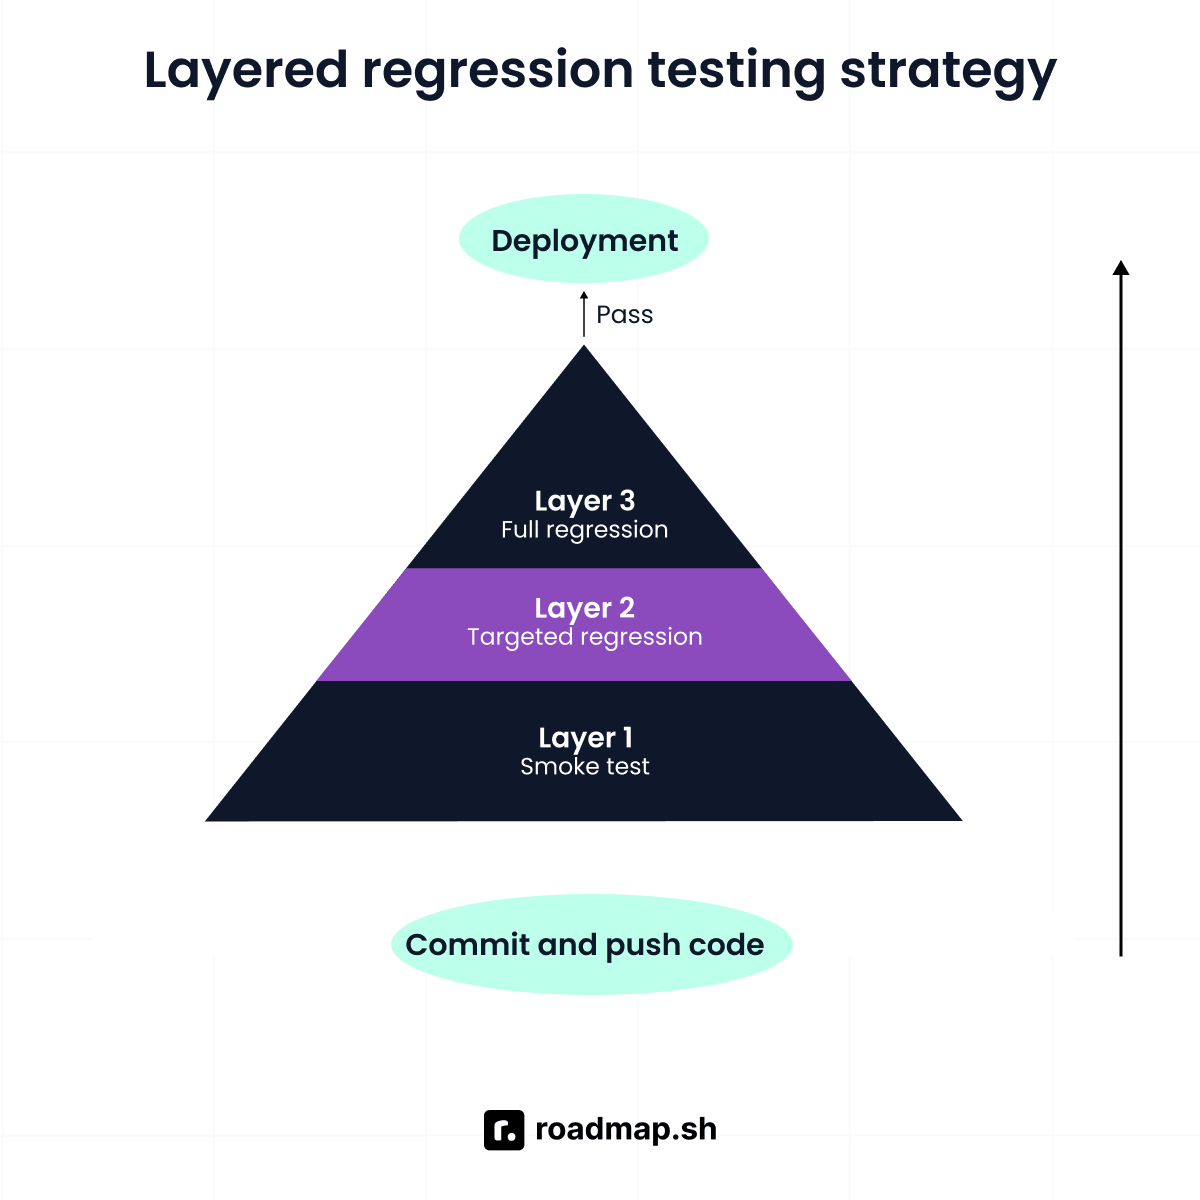
1-qatlam: Smoke test'lar
Smoke test'lar — ilova ishni davom ettirish uchun yetarlicha sog'lom ekanini aniqlaydigan kichik testlar to'plami. Ular har bir feature'ni tekshirish o'rniga doimo ishlashi shart bo'lgan critical path'larga e'tibor qaratadi. Bunga ilova muvaffaqiyatli ishga tushishi, foydalanuvchilar authentication'dan o'ta olishi, asosiy API endpoint'lari to'g'ri javob berishi va ilova ma'lumotlar bazasiga ulana olishini tekshirish kiradi.
Smoke test'lar har bir commit'da ishga tushadi. Ular taxminan ikki daqiqada tugaydigan qilib tuziladi va regression suite'ning qolgan qismi ishga tushishidan oldin yaqinda kiritilgan o'zgarish nosozlikka sabab bo'lgan-bo'lmagani haqida darhol feedback beradi.
Masalan, birinchi tekshiradigan narsalaringizdan biri — ilovaga ulanish mumkinligi. Quyidagi Playwright smoke test'i bosh sahifa muvaffaqiyatli yuklanishini va server HTTP 200 status kodi bilan javob berishini tekshiradi:
import { test, expect } from '@playwright/test';

test('homepage loads successfully', async ({ page }) => {
  await page.goto('http://localhost:3000);
await expect(page).toHaveTitle(/My App/i);

  const mainHeading = page.getByRole('heading', { level: 1 });
  await expect(mainHeading).toBeVisible();
});
2-qatlam: Targeted regression test'lar (pull request'da)
Ilovangiz smoke test'lardan o'tgach, keyingi qadam — ilovaning taklif qilinayotgan o'zgarishlar ta'sir qilishi ehtimoli eng yuqori bo'lgan qismlarini tekshirish.
Targeted regression test'lar o'zgartirilayotgan feature'ga va uning atrofidagi code path'larga e'tibor qaratadi. O'zgarish ko'lamiga qarab, bu test qatlami butun regression suite'ni ishga tushirmasdan ta'sirlangan funksionallikni tekshiradigan unit test'lar, integration test'lar va end-to-end test'larni o'z ichiga olishi mumkin.
Bu targeted test'lar pull request'larda ishga tushgani uchun ular dasturchilar merge qilishdan oldin natijalarni ko'rib chiqa olishlari uchun yetarli coverage berishi kerak. Ko'pchilik jamoalar bajarilish vaqti va mazmunli tekshiruv o'rtasida muvozanat saqlab, bu qatlamni besh daqiqadan yigirma daqiqagacha oraliqda ushlab turishga harakat qiladi.
Masalan, agar pull request foydalanuvchi profili endpoint'ini o'zgartirsa, u hamon ishlayotganiga ishonch hosil qilish uchun test yozishingiz mumkin. Quyidagi misolda Flask'ning test client'i Pytest bilan birga ishlatiladi:
def test_get_user_profile(client):
    response = client.get("/api/users/1")
    data = response.get_json()

    assert response.status_code == 200
    assert data["id"] == 1
    assert "email" in data
Bu test o'zgartirilgan endpoint'ga so'rov yuboradi va javobni tekshiradi. Agar API buzilsa yoki kutilmaganda o'zgarsa, test pull request merge qilinishidan oldin muvaffaqiyatsiz tugaydi.
3-qatlam: To'liq regression suite (har kecha yoki release oldidan)
Targeted regression test'lar muvaffaqiyatli o'tgach, navbat oxirgi qatlamga keladi. U ilovani bir butun sifatida tekshiradi.
To'liq regression suite barcha tegishli testlarni ishga tushiradi, jumladan end-to-end test'lar, cross-browser test'lar, performance regression tekshiruvlari va har bir kod o'zgarishidan keyin bajarish juda qimmatga tushadigan edge case'lar. Maqsad — faqat butun ilova birgalikda ishlatilgandagina ko'rinadigan muammolarni aniqlash.
Bu qatlamni tugatish 30 daqiqadan ikki soatgacha vaqt olishi mumkinligi sababli, u odatda har kecha jadval bo'yicha ishga tushadi yoki release branch merge yoki deploy qilinishidan oldin oxirgi quality gate vazifasini bajaradi. Bu yerda uzoqroq bajarilish vaqti maqbul, chunki dasturchilar ishini davom ettirish uchun natijalarni kutib o'tirmaydi.
Qo'llab-quvvatlash oson bo'lgan regression testlarni yozish
Feature'lar yaratishga sarflash mumkin bo'lgan vaqtni testlarni tuzatishga sarflashni istamaysiz. Ko'pchilik regression suite'larni qo'llab-quvvatlash qiyinlashib qolishiga sabab — UI'dagi kichik o'zgarishlar mavjud testlarning bir qismini buzishi. Bunga yo'l qo'ymaslikka yordam beradigan to'rtta amaliyot:
1. UI test'lar uchun Page Object Model (POM)'dan foydalaning: Faraz qiling, foydalanuvchini tizimga kiritadigan har bir test sahifa bilan ishlash amallarini o'zida saqlaydi. Endi UI'dagi kichik o'zgarish shu testlarning har birini yangilashni anglatadi. Buning o'rniga sahifa bilan ishlash amallarini bir joyda saqlang va testlaringiz ulardan qayta foydalansin. Page Object Model (POM) aynan shu maqsad uchun yaratilgan. Quyidagi misolda login flow Playwright yordamida qayta ishlatiladigan Page Object ichiga o'ralgan.
from playwright.sync_api import Page

class LoginPage:
    def __init__(self, page: Page):
        self.page = page
        self.username_input = page.get_by_label("Username")
        self.password_input = page.get_by_label("Password")
        self.login_button = page.get_by_role("button", name="Log in")

    def login(self, username: str, password: str):
        self.page.goto("http://localhost:3000/login")
        self.username_input.fill(username)
        self.password_input.fill(password)
        self.login_button.click()
Sahifa bilan ishlash amallarini Page Object bajargani uchun test kutilgan xatti-harakatni tekshirishga e'tibor qarata oladi. Bu misolda u to'g'ri credential'larga ega foydalanuvchi tizimga kirgandan keyin dashboard'ga yo'naltirilishini tekshiradi.
from playwright.sync_api import expect

def test_user_can_log_in(page):
    login_page = LoginPage(page)

    login_page.login(
        "username",
        "password"
    )

    expect(page).to_have_url("http://localhost:3000/dashboard")
2. Xatti-harakatni tekshiradigan testlar yozing: Feature haqiqatan ishlayotgan-ishlamayotganiga e'tibor qarating. Login misolida login tugmasi muayyan CSS selector'ga ega ekanini tekshirish o'rniga, foydalanuvchi tizimga kirgandan keyin dashboard'ga yetib borishini tekshiring. Aks holda login flow hamon ishlayotgan bo'lsa ham, UI'dagi kichik o'zgarish testni buzishi mumkin.
3. Testlarning bir-biriga bog'liqligidan qoching: Har bir regression test mustaqil ravishda ishga tusha olishi kerak. Bu test isolation deb ataladi. Masalan, agar bitta test foydalanuvchini ro'yxatdan o'tkazsa, boshqa test esa bu foydalanuvchi allaqachon mavjud deb hisoblasa, ikkinchi test endi birinchisiga bog'liq bo'lib qoladi. Buning o'rniga har bir test o'z ma'lumotlarini o'zi yaratsin va o'zi tozalasin. Bu parallelization'ni ham mumkin qiladi, chunki testlar endi bir-biriga tayanmaydi.
4. Fixture'lar yoki data factory'lardan foydalaning: Qiymatlarni hardcode qilish yoki umumiy test ma'lumotlar bazasiga tayanish o'rniga, testlaringizga kerakli ma'lumotlarni yaratish uchun test fixture yoki data factory'dan foydalaning.
Regression testlarni CI/CD pipeline'ga integratsiya qilish
Regression testlaringizni yozdingiz. Bu jarayonning faqat bir qismi. Keyingi qadam — ular qachon ishga tushishi kerakligini hal qilish. Ularni kimdir qo'lda ishga tushirishiga tayanish o'rniga, jarayonni avtomatlashtirish uchun GitHub Actions kabi CI/CD platformasidan foydalaning. Quyidagi workflow har bir push'da smoke test suite'ni, har bir pull request'da targeted regression test'larni ishga tushiradi va to'liq regression suite'ni har kecha ishga tushirish uchun cron job'dan foydalanadi.
name: Regression Tests

on:
  push:

  pull_request:
    branches:
      - main

  schedule:
    - cron: "0 2 * * *"

jobs:
  smoke:
    if: github.event_name == 'push'
    runs-on: ubuntu-latest

    steps:
      - uses: actions/checkout@v4

      - uses: actions/setup-node@v4
        with:
          node-version: 22

      - run: npm ci

      - run: npx playwright install --with-deps

      - name: Run smoke tests
        run: npx playwright test tests/smoke

  targeted-regression:
    if: github.event_name == 'pull_request'
    runs-on: ubuntu-latest

    steps:
      - uses: actions/checkout@v4

      - uses: actions/setup-node@v4
        with:
          node-version: 22

      - run: npm ci

      - run: npx playwright install --with-deps

      - name: Run targeted regression tests
        run: npx playwright test tests/regression
  full-regression:
    if: github.event_name == 'schedule'
    runs-on: ubuntu-latest

    steps:
      - uses: actions/checkout@v4

      - uses: actions/setup-node@v4
        with:
          node-version: 22

      - run: npm ci

      - run: npx playwright install --with-deps

      - name: Run full regression suite
        run: npx playwright test
Regression testlar CI/CD pipeline'ingizga integratsiya qilingach, har bir kod o'zgarishini production'ga yetib borishidan oldin tekshira olasiz. Integratsiyani samaraliroq qiladigan to'rtta amaliyot:
1. Fail fast: Fail-fast tamoyili muammolarni iloji boricha ertaroq aniqlaydi, shunda pipeline'ning qolgan qismini ishga tushirishga vaqt sarflamaysiz. Agar smoke test suite muvaffaqiyatsiz tugasa, pipeline'ni darhol to'xtating va davom etishdan oldin muammoni tuzating.
2. Parallel bajarish: Parallel bajarish regression suite'ingizni ishga tushirish uchun ketadigan umumiy vaqtni qisqartiradi. To'liq regression suite'ni bir nechta test runner'larga taqsimlang, shunda testlarning turli guruhlari bir vaqtning o'zida ishga tushadi.
3. Test natijalari hisobotlari: Muvaffaqiyatsiz testlarni aniqlash va tuzatishni osonlashtiring. Test hisobotlaringizga screenshot'lar, log'lar va boshqa foydali kontekstni qo'shing, shunda aynan nima va qayerda buzilganini bilasiz.
4. Flaky test'larni boshqarish: Flaky test'lar deploy'larni to'sib qo'yishiga yo'l qo'ymang. Agar test hech qanday kod o'zgarishisiz vaqti-vaqti bilan muvaffaqiyatsiz tugasa, uni ajratib qo'ying va root cause'ini aniqlang. Agar uni darhol tuzatib bo'lmasa, uni karantinga oling va regression suite'ga qaytarishdan oldin uni tuzatish uchun aniq Service Level Agreement yoki kutilgan muddatni belgilang.
Ushbu bo'limda yaratgan GitHub Actions workflow'ingiz regression testlarni CI/CD pipeline'ga integratsiya qilishning sinalgan usulidir. Xuddi shu tamoyillarni GitLab CI, Jenkins va CircleCI kabi boshqa CI/CD vositalarida ham amalga oshirish mumkin, garchi konfiguratsiya farq qilishi mumkin bo'lsa ham.
Agar Git, GitHub va zamonaviy software delivery ortidagi workflow'larni chuqurroq tushunmoqchi bo'lsangiz, Git & GitHub qo'llanmasi o'rganishni davom ettirish uchun yaxshi joy.
Regression testing framework'ini tanlash
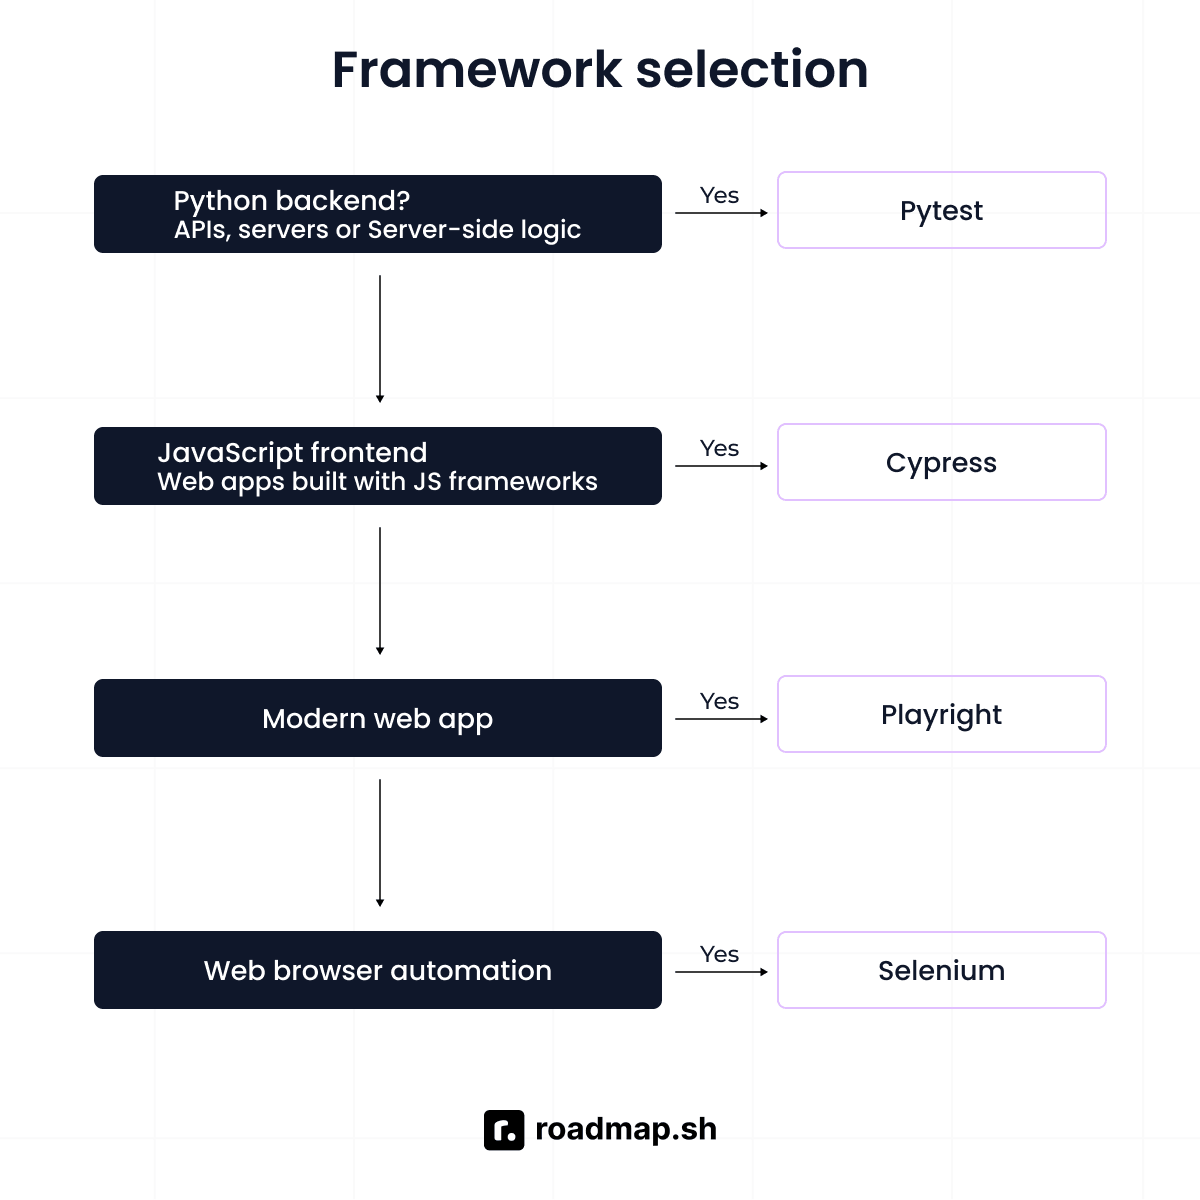
Bugungi kunda bir nechta regression testing framework'lari mavjud. To'g'ri tanlov sizning testing maqsadlaringiz, dasturlash tilingiz va qanday ilova yaratayotganingizga bog'liq. Quyida eng keng tarqalgan variantlar va ulardan qachon foydalanish kerakligi keltirilgan:
-
Playwright: Playwright — end-to-end va UI regression testing uchun tezkor, cross-browser testing framework. U Python, JavaScript va TypeScript'ni qo'llab-quvvatlaydi hamda browser automation va API testing uchun yagona vositani xohlaydigan jamoalar uchun yaxshi tanlov.
-
Pytest: Pytest — Python'da unit va integration regression testing uchun standart test runner. Uning boy plugin ekotizimi bor, jumladan test coverage uchun pytest-cov va parallel bajarish uchun pytest-xdist. Regression testlaringiz Python ilovalari, API'lar yoki backend servislarga qaratilgan bo'lsa, pytest'dan foydalaning.
-
Cypress: Cypress — brauzerga asoslangan regression testing uchun JavaScript framework'i. U test bajarilishini real vaqtda ko'rsatadi va JavaScript framework'lari bilan yaratilgan frontend ilovalar uchun juda mos keladi. Uning asosiy cheklovi shundaki, u faqat brauzerga asoslangan testing bilan chegaralangan va Chrome hamda Firefox'ni qo'llab-quvvatlaydi. Regression suite'ingiz brauzerga asoslangan frontend ilovalarga qaratilgan bo'lsa, Cypress'dan foydalaning.
-
Selenium: Selenium — browser automation va regression testing uchun eng keng qo'llaniladigan framework'lardan biri. U bir nechta dasturlash tilini qo'llab-quvvatlaydi va turli platformalarda keng cross-browser coverage taklif qiladi. To'rtta framework orasida uni qo'llab-quvvatlash eng ko'p mehnat talab qiladi, lekin mavjud Selenium suite'iga ega jamoalar yoki brauzer mosligi muhim bo'lgan loyihalar uchun kuchli tanlov bo'lib qolmoqda.
Automated regression testing'ning amaliy qo'llanilishi
Keyingi hal qilish kerak bo'lgan masala — regression testlarni qachon ishga tushirish. Quyidagi misollar automated regression testing software testing jarayonining qaysi joyiga mos kelishini ko'rsatadi.
1. CI/CD pipeline'lar: Regression testing jarayoningizni avtomatlashtirishning eng yaxshi usullaridan biri — uni CI/CD pipeline'ingiz orqali bajarish. Testlaringiz pipeline'ga ulangach, yangi kod push qilinganda ular avtomatik ravishda ishga tusha oladi. Keng tarqalgan automated testing strategiyasi — har bir commit'dan keyin smoke test'larni, pull request'lar uchun targeted regression test'larni va release oldidan to'liq regression testing'ni ishga tushirish. Bu kuniga bir necha marta deploy qiladigan jamoalar foydalanadigan pattern.
2. Dependency yangilanishlaridan keyin: Kutubxona yoki framework'ni yangilash, hatto o'z kodingizni o'zgartirmagan bo'lsangiz ham, breaking change'larni olib kirishi mumkin. Dependency yangilanganidan keyin, yangilanishni chiqarishdan oldin mavjud test case'lar hamon muvaffaqiyatli o'tishini tasdiqlash uchun to'liq regression suite'ni ishga tushiring. Bu o'z vaqtida chiqarilishi kerak bo'lgan security patch'larni qo'llashda foydali.
3. Database migration'ni tekshirish: Schema migration yoki data migration'dan keyin data access layer'da regression testlarni ishga tushiring, shunda query'lar kutilgan natijalarni qaytarishini va ilova ma'lumotlar bazasidan hamon to'g'ri o'qiy olishi hamda unga to'g'ri yoza olishini tasdiqlaysiz.
4. Cross-browser va cross-device tekshiruvi: Veb-ilovalar turli brauzer va qurilmalarda bir xil ishlamaydi, shuning uchun cross-browser coverage veb-ilovalarni testlashning asosiy qismi hisoblanadi. Rendering muammolari, layout buzilishlari yoki JavaScript bilan bog'liq nomuvofiqliklarni foydalanuvchilaringizga yetib borishidan oldin aniqlash uchun UI regression suite'ingizni bir nechta brauzer va qurilma konfiguratsiyalarida ishga tushiring.
5. API contract testing: Backend API'dagi kichik o'zgarish unga bog'liq barcha client ilovalarni buzishi mumkin. Mavjud so'rov va javoblar hamon kutilganidek ishlashini tasdiqlash uchun API contract'iga nisbatan regression testlarni ishga tushiring va breaking change'larni client ilovalar ularni sezishidan oldin aniqlang. Bu bir nechta servis bitta API'ga bog'liq bo'lgan microservices arxitekturalarida yanada muhimroq.
6. Pre-release gating: Production yoki release branch'ga merge qilishdan oldin jamoalar to'liq regression suite'ni release gate sifatida ishga tushiradi. Agar test muvaffaqiyatsiz tugasa, muammo tuzatilmaguncha yoki test xatti-harakatdagi ataylab kiritilgan o'zgarishni aks ettiradigan qilib yangilanmaguncha release bloklanadi.
7. LLM prompt va model evaluation: AI ilovalariga ham regression testing kerak. Prompt'ni yangilaganingizda, yangi model'ga o'tganingizda yoki retrieval konfiguratsiyasini o'zgartirganingizda, deploy qilishdan oldin golden dataset'ga nisbatan regression evaluation o'tkazing. Xuddi dependency yangilanishidagi kabi, kod o'zgarmay qolishi mumkin, ilova tayanadigan biror narsa esa o'zgaradi. Evaluation foydalanuvchilarga ta'sir qilishidan oldin javob sifati pasaymaganini tasdiqlaydi.
LLM ilovalari uchun regression testing
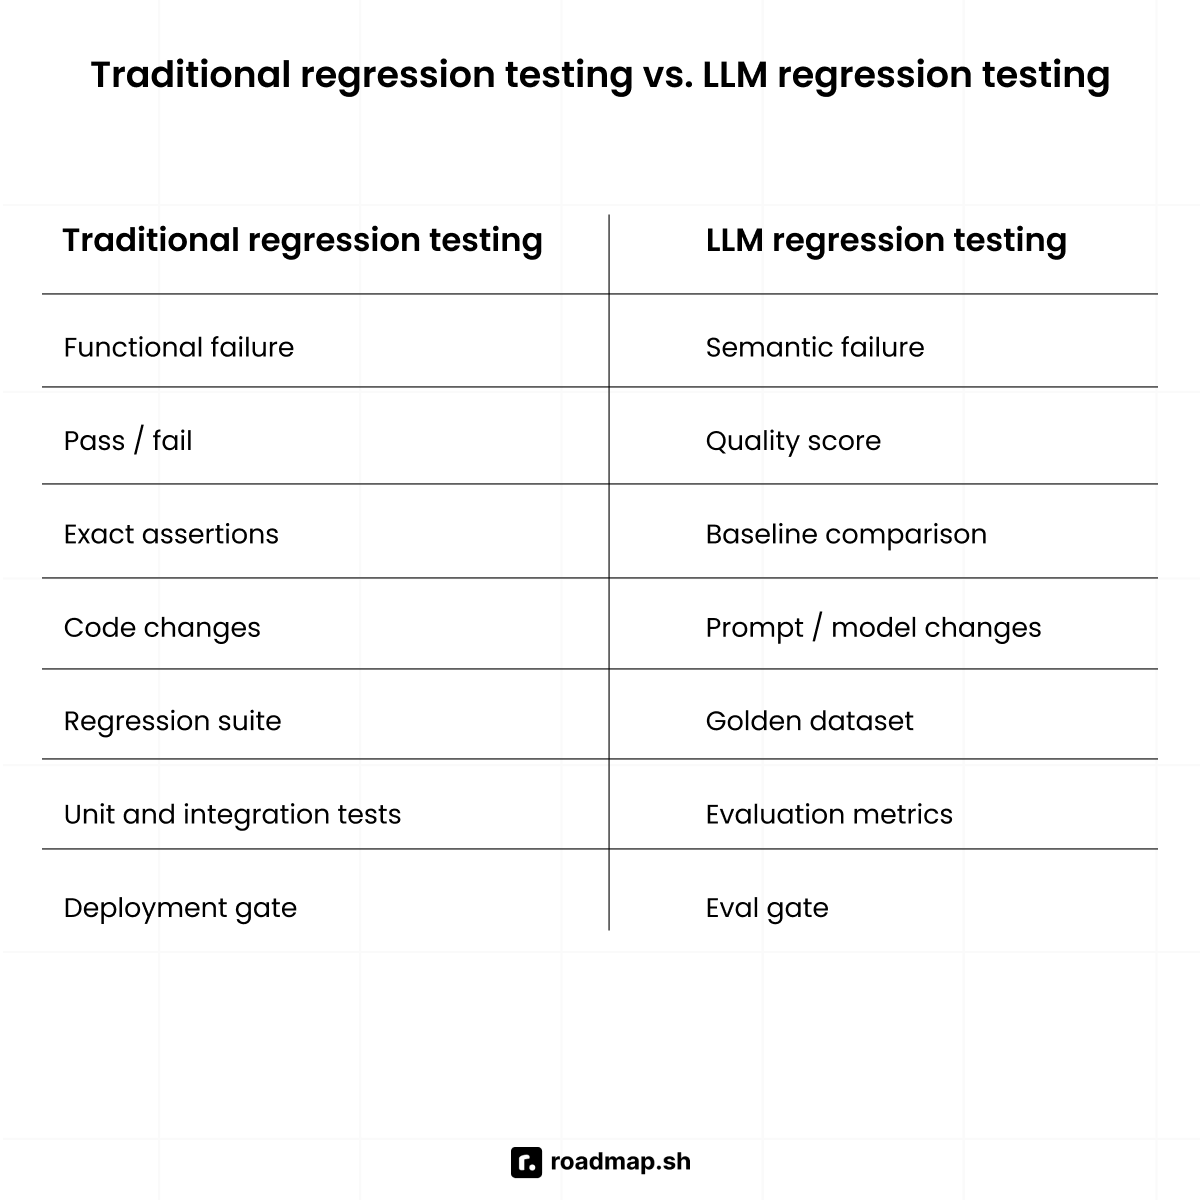
An'anaviy regression testing funksional nosozliklarni aniqlaydi: ilova bajarishi kerak bo'lgan, lekin endi bajarmayotgan narsani. Funksiya noto'g'ri qiymat qaytaradi, sahifa yuklanmaydi yoki API 500 xatosi bilan javob beradi. LLM regression testing esa semantik nosozliklarni aniqlaydi: ilova hamon javob beradi, lekin javob faktik jihatdan noto'g'ri, avvalgisiga qaraganda sifati pastroq yoki oldingi natijalarga mos kelmaydigan bo'lishi mumkin. Bu nosozliklar kamdan-kam hollarda xato signalini beradi, shuning uchun javob sifati pasaygan bo'lsa ham, standart monitoring hammasi joyida deb ko'rsatishi mumkin.
LLM regression testing'ni nima farqli qiladi
An'anaviy regression testing'da test yo muvaffaqiyatli o'tadi, yo muvaffaqiyatsiz tugaydi. LLM evaluation esa spektr asosida ishlaydi. Javob qisman to'g'ri, boshqacha ifodalangan, lekin semantik jihatdan teng yoki oldingi javobdan biroz yomonroq bo'lishi mumkin. Sifat regression'larini aniqlash uchun exact-match assertion'larga tayanish o'rniga, yangi natijalarni baseline bilan solishtiring. Buning sababi, semantik nosozlik ko'pincha ilova xatosi emas, balki javob sifatining pasayishi bo'ladi.
LLM regression run'ini ishga tushirishga sabab bo'ladigan uchta keng tarqalgan omil bor:
-
Prompt o'zgarishlari: Hatto so'zlardagi kichik o'zgarish ham javob sifatiga sezilarli ta'sir qilishi yoki hallucination'larni ko'paytirishi mumkin.
-
Model yangilanishlari: Provider'ni almashtirish, yangiroq model'ga o'tish yoki temperature kabi parametrlarni o'zgartirish bir xil prompt uchun turli natijalar berishi mumkin.
-
Retrieval konfiguratsiyasidagi o'zgarishlar: RAG ilovalarida chunk size, embedding model yoki retrieval threshold'ni o'zgartirish ilova kodining birorta qatorini o'zgartirmasdan ham javobning faithfulness'ini pasaytirishi mumkin.
Maqsad an'anaviy regression testing bilan bir xil: kod regression testlari funksional regression'larni merge'dan oldin aniqlaganidek, sifat regression'larini deploy qilishdan oldin aniqlash.
LLM regression test suite'ini qurish
LLM regression test suite'ini qurish prompt va model o'zgarishlarida javob sifatini o'lchashdan boshlanadi. Quyidagi tarkibiy qismlar natijalarni baholash va regression'larni aniqlashning yaxshi usuli:
-
Golden dataset: Namunaviy prompt'lar, kutilgan javoblar yoki sifat rubric'laridan foydalanib golden dataset yarating. Unga foydalanuvchilar eng ko'p beradigan savollarni, muhim edge case'larni va javob sifati eng katta ahamiyatga ega bo'lgan boshqa yuqori xavfli holatlarni kiriting.
-
Evaluation metrikalari: LLM regression test'ini o'tkazishdan oldin ilovangiz uchun sifat nimani anglatishini belgilang. Keng tarqalgan evaluation metrikalariga faithfulness (javob manba materialini aniq aks ettiradimi), relevance (javob savolga mos keladimi), hallucination rate (javob kontekstda mavjud bo'lmagan faktlarni qo'shadimi) va task completion (model ko'zlangan maqsadga erishdimi) kiradi. Regression'lar ballarning pasayishi sifatida ko'rinishi uchun bu ballarni run'lar davomida kuzatib boring.
-
Javoblarni boshqa model yordamida baholash: Ochiq javobli natijalar uchun aniq moslikni tekshirish yaxshi ishlamaydi, shuning uchun odatda ularni evaluation rubric'ingiz asosida boshqa LLM'ga baholatasiz. Bu javoblarni katta hajmda baholashning eng oson usuli. E'tibor berish kerak bo'lgan narsalardan biri — izchillik. Bitta judge model aynan bir xil javobni turlicha baholashi mumkin, shuning uchun jamoalar odatda temperature'ni 0 ga o'rnatadi va tuzilmali baholash prompt'laridan foydalanadi.
-
Human annotation: Yuqori xavfli ilovalar uchun javoblarning bir qismini human annotation orqali tekshiring. Inson tomonidan ko'rib chiqish LLM judge'ni kalibrlashga yordam beradi va avtomatik ballar javobning haqiqiy sifati bilan mos kelishini tasdiqlaydi.
LLM evaluation'ni CI/CD'ga integratsiya qilish
LLM regression evaluation, xuddi unit va regression testlar kabi, CI/CD pipeline'ingizning bir qismi bo'lishi kerak. Agar prompt yoki model yangilanishi faithfulness balining qabul qilingan baseline threshold'dan pastga tushishiga sabab bo'lsa, foydalanuvchilarga sifati pastroq javoblarni yetkazish o'rniga deploy muvaffaqiyatsiz tugashi kerak. Odatiy LLM evaluation workflow'i quyidagicha ko'rinadi:
1. Asosiy pipeline: Golden dataset'ni yangilangan prompt yoki model versiyasi orqali o'tkazing, javoblarni evaluation metrikalaringiz yordamida baholang, natijalarni oldingi versiya bilan solishtiring va agar biror metrika belgilangan tolerance'dan ortiq pasaysa, CI/CD pipeline deploy'ni bloklasin.
Quyida ikkita prompt versiyasini baholash uchun MLflow'dan foydalanadigan qisqa Python misoli keltirilgan:
import mlflow

# former prompt scores
baseline = {
    "faithfulness": 0.94,
    "relevance": 0.96,
}

# New prompt scores
candidate = {
    "faithfulness": 0.89,
    "relevance": 0.95,
}

THRESHOLD = 0.90

with mlflow.start_run(run_name="prompt-v1-evaluation"):
    for metric, value in baseline.items():
        mlflow.log_metric(metric, value)

with mlflow.start_run(run_name="prompt-v2-evaluation"):
    for metric, value in candidate.items():
        mlflow.log_metric(metric, value)

# Don't deploy if the score falls below the threshold
if candidate["faithfulness"] < THRESHOLD:
    raise SystemExit(
        f"Deployment blocked: faithfulness score "
        f"({candidate['faithfulness']:.2f}) is below the threshold ({THRESHOLD:.2f})."
    )

print("Evaluation passed. Safe to deploy.")
Bu misol eval-gated deployment ortidagi asosiy g'oyani ko'rsatadi. Yangi prompt baholanadi, uning ballari baseline bilan solishtiriladi va agar muhim metrika qabul qilingan threshold'dan pastga tushsa, deploy avtomatik ravishda bloklanadi.
2. Eval-gated deployment'larni qo'llab-quvvatlaydigan vositalar: Bir nechta vosita evaluation workflow'ining turli qismlarini avtomatlashtiradi. Braintrust eval pass/fail gate'larini CI/CD pipeline'larga integratsiya qiladi. MLflow eksperimentlarni kuzatadi va evaluation metrikalarini prompt versiyalari bo'yicha solishtiradi. Langfuse prompt versioning'ni va o'zgarishdan oldingi hamda keyingi sifatni solishtirishni qo'llab-quvvatlaydi. Kengroq sharh uchun LLM observability vositalari bo'yicha qo'llanmani ham ko'rib chiqishingiz mumkin.
3. Amaliy qiyinchilikka e'tibor bering: LLM evaluation'lari unit test'larga qaraganda sekinroq va qimmatroq, shuning uchun har bir commit'da to'liq golden dataset'ni ishga tushirish amaliy emas. Kod regression testing'ida qo'llaniladigan qatlamli yondashuv bu yerda ham amal qiladi: har bir pull request'da golden dataset'ning kichikroq, yuqori ustuvorlikka ega qismini, to'liq golden dataset'ni esa har kecha jadval bo'yicha yoki yirik release'lar oldidan ishga tushiring.
Keng tarqalgan xatolar va best practice'lar
Software engineering jamoalari, QA engineer'lar va AI engineer'lar — barchasi test automation'dagi bir xil xatolarga duch keladi. Quyida ularni eng ko'p qoqiltiradigan narsalar va ulardan qanday qochish mumkinligi keltirilgan.
Qochish kerak bo'lgan keng tarqalgan xatolar
-
Har bir commit'da to'liq suite'ni ishga tushirish: Har bir commit'da ishlaydigan 60 daqiqalik suite tezkor feedback'ni yo'q qiladi va odamlarni testlarni o'tkazib yuborishga undaydi. Buning o'rniga qatlamli yondashuvdan foydalaning: commit'da smoke test'lar, jadval bo'yicha esa to'liq suite.
-
Xatti-harakat o'rniga implementation'ni test qilish: CSS selector'lar yoki element ID'lariga bog'langan testlar, hatto aslida hech narsa buzilmagan bo'lsa ham, UI'dagi har bir o'zgarishda buziladi. Kod buni qanday bajarishini emas, foydalanuvchi nima qila olishini test qiling.
-
Test isolation'ni e'tiborsiz qoldirish: Ma'lumotlar bazasi, login sessiyasi yoki global o'zgaruvchini birgalikda ishlatadigan testlar bajarilish tartibi o'zgarishi yoki run'lar parallel bo'lishi bilanoq tasodifiy tarzda muvaffaqiyatsiz tugaydi. Har bir test o'z holatini o'zi yaratishi va o'zi tozalashi kerak.
-
Flaky test'larning to'planib qolishiga yo'l qo'yish: Vaqtning 10 foizida muvaffaqiyatsiz tugaydigan test arzimas narsa emas; u butun suite'ga bo'lgan ishonchni yo'qqa chiqaradi. Muvaffaqiyatsizliklarni e'tiborsiz qoldira boshlaganingizdan keyin suite o'z vazifasini bajarmay qo'yadi. Flaky test'larni tezda karantinga oling va ularni tuzatish uchun muddat belgilang.
-
Ataylab kiritilgan o'zgarishlardan keyin test suite'ni hech qachon yangilamaslik: Agar feature ataylab o'zgartirilsa, test ham u bilan birga o'zgarishi kerak. Aks holda pipeline'larni bloklaydigan va engineer'larni natijalarga ishonmaslikka o'rgatadigan soxta muvaffaqiyatsizliklarga duch kelasiz.
-
Haddan tashqari avtomatlashtirish: Exploratory testing, usability tekshiruvlari va murakkab edge case'lar hamon tester'ning mulohazasini talab qiladi. Manual testing eskirmagan, u shunchaki avtomatlashtirish kabi masshtablanmaydi. Barqaror, takrorlanuvchi va yuqori qiymatga ega ishlarni avtomatlashtiring, qolganini esa QA engineer'laringizga qoldiring.
Best practice'lar
-
Eng yuqori xavfli yo'ldan boshlang: User journey'laringizga tanqidiy nazar bilan qarang. Avval login, checkout va to'lov flow'larini avtomatlashtiring. Admin sozlamalaridagi xato faqat admin foydalanuvchining jig'iga tegishi mumkin, lekin checkout flow'dagi nosozlik — bu production incident.
-
Test pyramid'ni qo'llang: Unit test'lar asosda turadi; ular tez, arzon va mantiqni batafsil qamrab oladi. Automated regression test case'laringizning aksariyati aynan shu yerda bo'lishi kerak. Integration test'lar o'rtada joylashib, component'lar birgalikda ishlashini tekshiradi. End-to-end test'lar eng yuqorida turib, muhim foydalanuvchi flow'lari hamon ishlayotganini tasdiqlaydi. Testlaringizning ko'proq qismini pyramid'ning pastki qismida saqlang; aynan shu yerda ularni ishga tushirish ham, qo'llab-quvvatlash ham arzon.
-
Change-based test selection'dan foydalaning: Har bir PR'da barcha 2000 ta testni ishga tushirish o'rniga, aslida o'zgargan kodni qaysi testlar qamrab olishini aniqlang va faqat ularni ishga tushiring. Pytest-coverage mapping va Playwright'ning component darajasidagi test tagging'i kabi regression testing vositalari bunga yordam berishi mumkin.
-
Bajarishni parallellashtiring: Bu continuous testing'ni tez saqlaydi. Wall-clock vaqtini qisqartirish uchun test suite'ni bir nechta runner'larga taqsimlang. 60 daqiqalik suite'ni ko'pincha oltita parallel runner yordamida 10 daqiqadan kamroq vaqtga tushirish mumkin.
-
Testlarga production kodi kabi munosabatda bo'ling: Ilova kodiga qo'llaydigan code review standartlari, nomlash konvensiyalari va refactoring intizomini test kodiga ham qo'llang. Xuddi shu intizom automated test skriptlaringizga ham tatbiq etilishi kerak. Yomon tuzilgan testlar regression suite'ning maintenance debt'ini yuzaga keltiradigan asosiy manbalardan biri.
Xulosa
Automated regression testing har bir release'ga shubha bilan qaramasdan kodni barqaror yetkazib berishga imkon beradi. Ushbu qo'llanma davomida biz qatlamli strategiyani ko'rib chiqdik: smoke test'lar muammolarni har bir commit'da, targeted regression test'lar har bir PR'da aniqlaydi, to'liq suite esa qolganini tunda aniqlaydi, shunda siz sekin testlar girdobida qolib ketmaysiz. Ular birgalikda har bir bosqichda foydali feedback beradi. Aloqasi yo'q narsani buzadigan zararsiz o'zgarishni foydalanuvchilaringizdan oldin to'xtatadigan narsa — aynan qatlamli suite.
Xuddi shu g'oya LLM ilovalariga ham tegishli. Har bir prompt o'zgarishi va model yangilanishida ishga tushiriladigan golden dataset evaluation suite LLM deploy'lari uchun regression suite kod uchun qiladigan ishni qiladi: ularni taxmin emas, balki tizimli va ishonchli jarayonga aylantiradi. Ikkala holatda ham suite engineer'lar unga qanchalik ishonsa, shunchalik foydali bo'ladi.
Testing kengroq software delivery pipeline'ga qanday mos kelishini tushunish uchun AI Engineer va QA roadmap'larini o'rganing. Tezroq va ko'proq ishonch bilan o'rganishingizga yordam berish uchun AI Tutor ham mavjud.