NoSQL ma'lumotlar bazalari turlari: to'g'risini qanday tanlash kerak
Key-value, document, wide-column yoki graph? NoSQL ma'lumotlar bazasining har bir turi qanday ishlashini bilib oling va ilovangiz ma'lumotlari hamda query'lari uchun mosini tanlang.
Muallif: Ekene Eze
Backend developer sifatida siz relational ma'lumotlar bazasi nima ekanini allaqachon bilasiz va "NoSQL ma'lumotlar bazasi" degan atamani eshitganingizda, ehtimol, darhol MongoDB xayolingizga keladi. Ammo MongoDB — NoSQL ma'lumotlar bazalarining to'rtta asosiy turidan biri bo'lgan document ma'lumotlar bazasining bor-yo'g'i bitta misoli. Bu ma'lumotlar bazasi turlari turli xil ma'lumotlar va query pattern'lari uchun mo'ljallangan va ulardan to'g'risini tanlash ko'pincha haqiqiy qiyinchilikning o'zi bo'ladi. Noto'g'risini tanlasangiz, faqat sekinroq query'larga ega bo'lib qolmaysiz. Ilovangizga kerak bo'lgan query'larni yozishning deyarli iloji yo'qligini ham anglab qolishingiz mumkin.
"Not only SQL" (faqat SQL emas) degan ma'noni anglatuvchi NoSQL relational SQL ma'lumotlar bazalarining ma'lumotlarni saqlash va olish usulidan boshqacha ishlaydi. Ular muayyan ma'lumotlar tuzilmasiga mos keladigan moslashuvchan data model'lar bilan ishlash uchun yaratilgan: oddiy key-value juftligi, ichma-ich joylashgan (nested) document, wide column yoki ma'lumotlar o'rtasidagi bog'lanishlar tarmog'i. Ba'zi zamonaviy ma'lumotlar bazalari hatto bir nechta modelni bitta tizimda birlashtiradi — ular ko'pincha multi-model ma'lumotlar bazalari deb ataladi. Bu ma'lumotlar bazasi turlari bir-biridan qanday farq qilishini tushunish ilovangiz ma'lumotlari va query pattern'lari uchun to'g'ri modelni tanlashga yordam beradi.
Ushbu qo'llanmada siz NoSQL ma'lumotlar bazalarining to'rtta asosiy turi va ularning har biri qaysi muammolarni hal qilishi haqida bilib olasiz, shunda loyihangizning aniq use case'iga asoslanib, puxta o'ylangan tanlov qila olasiz.
TL;DR
NoSQL ma'lumotlar bazasining to'g'ri turini tanlash, oxir-oqibat, data engineering masalasidir. Bu ma'lumotlaringizning shakliga va ilovangiz ularni qanday query qilishi kerakligiga bog'liq. Har birini batafsil ko'rib chiqishdan oldin qisqacha sharh:
Key-value ma'lumotlar bazasidan foydalaning, agar…
-
Access pattern'ingiz sodda bo'lsa, masalan, qiymatni ma'lum key bo'yicha olish va boshqa hech narsa.
-
Sizga o'qish/yozish uchun mutlaqo eng past latency kerak bo'lsa.
-
Ma'lumotlaringiz query qilinishi kerak bo'lgan murakkab ichki tuzilmaga ega bo'lmasa.
Document ma'lumotlar bazasidan foydalaning, agar…
-
Ma'lumotlaringiz tabiatan ierarxik va obyektga o'xshash bo'lsa. Masalan, nested attribute'larga ega mahsulot, ichiga sozlamalar joylangan foydalanuvchi profili yoki izohlari bor blog post.
-
Schema'ngiz tez-tez o'zgarib tursa.
-
Faqat bitta key bo'yicha qidirish emas, balki document'lar ichida query qilish kerak bo'lsa.
Wide-column ma'lumotlar bazasidan foydalaning, agar…
-
Ko'plab node'lar bo'ylab taqsimlangan juda katta hajmdagi yozish operatsiyalari bilan ishlashingiz kerak bo'lsa.
-
Ma'lumotlaringiz time-series, event log'lar, sensor ma'lumotlari yoki tez-tez yoziladigan va vaqt oralig'i bo'yicha o'qiladigan har qanday pattern bo'lsa.
-
Node'larning yuqori darajada mavjud bo'lishini va node'lardagi nosozliklarga samarali bardosh bera olishni istasangiz.
Graph ma'lumotlar bazasidan foydalaning, agar…
-
Ma'lumot nuqtalari o'rtasidagi bog'lanishlar ma'lumotlarning o'zi kabi muhim bo'lsa.
-
Bog'lanishlar bo'ylab traverse qilish kerak bo'lsa, masalan, xarid pattern'lariga asoslangan mahsulot tavsiyalarini qidirish.
-
Query'laringiz SQL'da ko'plab qimmat
JOINstalab qiladigan, chuqurligi o'zgaruvchan traversal'ni o'z ichiga olsa.
NoSQL ma'lumotlar bazalari turlari: taqqoslash jadvali
Quyidagi jadvalda bu NoSQL ma'lumotlar bazasi turlari bir-biri bilan qanday taqqoslanishini ko'rib chiqaylik:
| Key-Value | Document | Wide-Column | Graph | |
|---|---|---|---|---|
| Data model | Key'ga moslangan qiymat | JSON/BSON document'lar | Moslashuvchan column'larga ega row'lar | Node'lar, edge'lar va property'lar |
| Query modeli | Faqat key bo'yicha qidirish | Istalgan maydon bo'yicha query | Partition key va column oraliqlari bo'yicha query | Graph traversal |
| Schema | Schema'siz | Moslashuvchan (ixtiyoriy validatsiya) | Qat'iy family'lar, moslashuvchan column'lar | Schema'siz |
| Eng mos keladigan sohalar | Keshlash, session'lar, real-time qidiruvlar | Veb-ilova backend'lari, kontent, kataloglar | Time-series, event log'lar, juda katta write throughput | Fraud detection, ijtimoiy tarmoqlar, tavsiyalar |
| Horizontal scaling | A'lo | Yaxshi | A'lo (o'rnatilgan distributed dizayn) | O'rtacha (katta miqyosda murakkab) |
| ACID transaction'lar | Cheklangan | Multi-document (MongoDB 4.0+) | Cheklangan | Ha (Neo4j, Neptune; implementatsiyaga qarab farq qiladi) |
| Yetakchi misollar | Redis, DynamoDB | MongoDB, Firestore, CouchDB | Cassandra, HBase, ScyllaDB | Neo4j, Amazon Neptune, JanusGraph |
NoSQL ma'lumotlar bazalarining qanday turlari bor?
NoSQL 2000-yillarning oxirida, Web 2.0'ning shiddatli o'sishi an'anaviy relational ma'lumotlar bazalarini (RDBMS) amaliy chegaralaridan tashqariga chiqarib yuborganda paydo bo'ldi. Bu o'zgarishga uchta asosiy muammo sabab bo'ldi: scalability cheklovlari, qat'iy schema'lar va high availability'ga erishishning yuqori narxi. Bunga javoban, shu talablarga yaxshiroq mos keladigan turli data model'lar va distributed arxitekturalarga ega yangi turdagi ma'lumotlar bazalari ishlab chiqildi.
Nomiga qaramay, ko'plab NoSQL ma'lumotlar bazalari Cassandra'ning CQL'i va Cosmos DB'ning SQL API'si kabi SQL'ga o'xshash query tillarini qo'llab-quvvatlaydi. NoSQL ma'lumotlar bazalarining belgilovchi xususiyati shundaki, ular relational jadvaldan asosiy data model sifatida foydalanmaydi.
Bu trade-off CAP theorem deb nomlanuvchi tushunchaga borib taqaladi. U distributed tizimlarning uchta xususiyatini tavsiflaydi: consistency, availability va partition tolerance. Distributed tizimlarda network partition'lardan qochib bo'lmagani sababli, partition yuz berganda ma'lumotlar bazasi consistency va availability o'rtasida tanlov qilishi kerak. An'anaviy relational ma'lumotlar bazalari qat'iy, ACID-style consistency tomon og'adi, aksariyat NoSQL ma'lumotlar bazalari esa availability'ni afzal ko'radi va eventual consistency'ni qabul qiladi — bunda replica'lar darhol yangilanmasdan, vaqt o'tishi bilan bir-biriga yetib oladi. Bu trade-off'ni tushunish workload'ingiz uchun to'g'ri NoSQL turini tanlashda juda muhim.
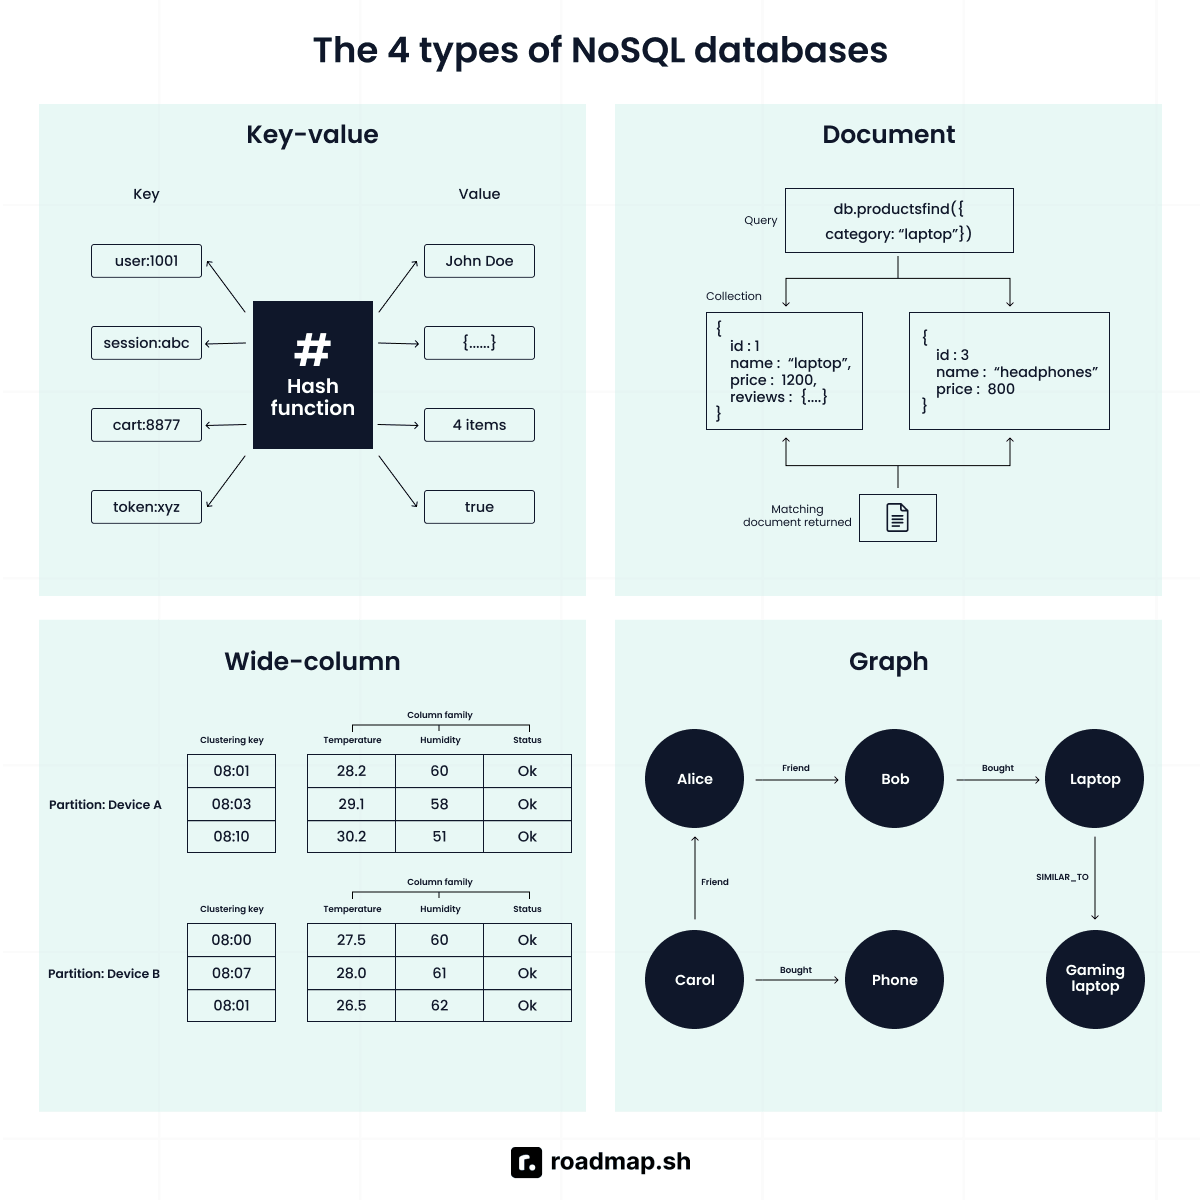
NoSQL ma'lumotlar bazalari ma'lumotlarni qanday modellashtirishi va saqlashiga qarab to'rtta asosiy toifaga bo'linadi. Har bir toifaning o'z kuchli tomonlari, trade-off'lari va ideal use case'lari bor — ular keyingi bo'limlarda chuqur ko'rib chiqiladi.
Key-value ma'lumotlar bazalari
Key-value ma'lumotlar bazalari — NoSQL'ning eng sodda turi. Har bir ma'lumot juftlik sifatida saqlanadi: noyob key va qiymat (value). Qiymat oddiy string, butun son, murakkab blob yoki serialize qilingan JSON obyekt bo'lishi mumkin. Bunday ma'lumotlar bazasi qiymat ichidagi tuzilmani bilmaydi va unga ahamiyat ham bermaydi; buning o'rniga u faqat qiymatni key bo'yicha qanday topish va qaytarishni biladi. Mashhur key-value ma'lumotlar bazalari: Redis, Amazon DynamoDB va Memcached.
Key-value ma'lumotlar bazalari qanday ishlaydi
Row va column'larni boshqarish o'rniga ilovangiz shunchaki foydalanuvchi ID'si yoki session token kabi aniq identifikatorni so'raydi va ma'lumotlar bazasi darhol tegishli payload'ni qaytaradi. Oddiy matnmi, rasmning binary ma'lumotimi yoki tuzilmali JSON obyektmi — nimani saqlayotganingizdan qat'i nazar, ma'lumotlar bazasi bu qiymatga butunlay moslashuvchan blob sifatida qaraydi. Ma'lumotlarni validatsiya qilishni u to'liq ilovangiz kodiga qoldiradi.
Masalan, Redis'da foydalanuvchi session'ini quyidagicha saqlaysiz va olasiz:
SET session:abc123 '{"user_id": 42, "cart": [101, 205]}'
GET session:abc123

"{\"user_id\": 42, \"cart\": [101, 205]}"
Ma'lumotlar bazasi qiymat ichidagi JSON'ni parse qilmaydi va tushunmaydi, u shunchaki o'sha key ostida saqlangan xom blob'ni chiqarib beradi.
Ichki tomondan, query bajarilganda ma'lumotlar bazasi relational tizimlarga xos bo'lgan odatiy disk qidiruvlari va murakkab table join'larni chetlab o'tadi. U o'sha key joylashgan aniq xotira manziliga to'g'ridan-to'g'ri ishora qilish uchun ichki hash table yoki index'dan foydalanadi. Bu algoritmik qisqa yo'l ma'lumotlar bazasi istalgan ma'lumotni bir zumda topa olishini anglatadi va siz o'nta yoki o'n millionlab faol foydalanuvchi session'larini kuzatayotganingizdan qat'i nazar, tezkor javob vaqtini saqlab qoladi.
Kuchli tomonlari
-
Juda yuqori tezlik: Masalan, Redis bitta node'da sekundiga millionlab operatsiyani bajara oladi. Bunga asosan O(1) key lookup'lar sabab bo'ladi.
-
Soddalik: Ular oldindan data model dizaynini deyarli talab qilmaydi, shuning uchun ularni tushunish va ular bilan ishlash oson.
-
Kuchli ma'lumotlar tuzilmalari: Redis list'lar, set'lar, sorted set'lar, hash'lar, stream'lar va pub/sub'ni qo'llab-quvvatlaydi va key-value juftliklaridan tashqari ko'proq funksionallikni taqdim etadi.
-
Avtomatik muddati tugashi: Time-To-Live (TTL) deb ham ataladi — key'larni avtomatik ravishda muddati tugaydigan qilib sozlash mumkin, bu ularni keshlash va session management uchun juda mos qiladi.
Cheklovlari
-
Cheklangan query imkoniyatlari: Key-value ma'lumotlar bazalari saqlangan qiymatlar ichidagi maydonlarni o'z vositalari bilan query qila olmaydi, shuning uchun ma'lum maydon bo'yicha filtrlash odatda ilova kodida har bir qiymatni o'qib chiqishni talab qiladi.
-
Bog'lanishlar yo'q: Turli key'lar o'rtasidagi bog'lanishlarni modellashtirishning o'rnatilgan usuli yo'q, bu o'zaro bog'langan ma'lumotlarni ifodalashni qiyinlashtiradi.
-
Xotira cheklovlari: Redis kabi in-memory key-value ma'lumotlar bazalari mavjud RAM hajmi bilan cheklangan, bu ular samarali saqlay oladigan dataset hajmini cheklashi mumkin.
Amalda, jamoaning workload'i relational ma'lumotlar bazasining imkoniyatlaridan oshib ketganda, unga maxsus caching logic'ni yopishtirishga urinish ko'pincha ortiqcha murakkablik qo'shadi, vazifalarni aralashtirib yuboradi va vaqt o'tishi bilan qo'llab-quvvatlash qiyinlashadi. Vaqtinchalik ma'lumotlar bilan ishlash uchun alohida key-value ma'lumotlar bazasini joriy etish ancha tezroq, toza va qo'llab-quvvatlash osonroq bo'lgan pattern hisoblanadi.
Document ma'lumotlar bazalari
Document ma'lumotlar bazalari ma'lumotlarni o'z-o'zini to'liq tavsiflaydigan JSON yoki BSON document'lar sifatida saqlaydi. Key-value ma'lumotlar bazalaridan farqli o'laroq, document ma'lumotlar bazasi har bir document ichidagi ma'lumotlar tuzilmasini tushunadi va alohida ma'lumot elementlarini index qilishi hamda query qilishi mumkin. Mashhur document ma'lumotlar bazalari: MongoDB, Firestore, Couchbase va Amazon DocumentDB. Ular ayniqsa tuzilmali va yarim tuzilmali ma'lumotlar bitta collection ichida birga mavjud bo'lgan holatlarda foydali, masalan, content management tizimlari, e-commerce kataloglari va foydalanuvchi profillari.
Document ma'lumotlar bazalari qanday ishlaydi
Ma'lumotlar bazasidagi har bir document bitta yozuv uchun barcha ma'lumotlarni, jumladan nested obyektlar va massivlarni o'z ichiga oladi, shuning uchun bog'liq ma'lumotlar bir joyda turadi. Bitta collection'dagi document'lar turli tuzilmalarga ham ega bo'lishi mumkin, bu esa ma'lumotlar bazasi schema'sini o'zgartirmasdan turli maydonlarga ega yozuvlarni saqlashni osonlashtiradi.
Masalan, mahsulot document'i nested inventory obyekti va sharhlar massivini o'z ichiga olishi mumkin — barchasi bitta document ichida.
{

  "name": "Macbook M4",

  "category": "laptop",

  "price": 950,

  "inventory": {

    "warehouse": 28

  },

  "reviews": [

    { "rating": 5 }

  ]

}
db.products.find({“category”: “laptop”, “price”: {“$lt”: 1000}}) kabi query document maydonlari bo'yicha to'g'ridan-to'g'ri qidirib, narxi $1000 dan past bo'lgan barcha noutbuklarni qaytaradi. Index'larni ham yuqori darajadagi, ham nested maydonlarda yaratish mumkin, bu ma'lumotlar bazasiga butun collection'ni skanerlash o'rniga mos document'larni samarali topish imkonini beradi.
Kuchli tomonlari
-
Document'lar ilova kodidagi obyektga to'g'ridan-to'g'ri mos keladi, shuning uchun bir nechta jadvaldan ma'lumotlarni yig'ish uchun ORM qatlami kerak bo'lmaydi.
-
Moslashuvchan schema'si document'ga yangi ma'lumot elementlarini migration'siz qo'shish imkonini beradi.
-
MongoDB'ning sharding'i document'larni bir nechta node'lar bo'ylab avtomatik ravishda taqsimlaydi va gigabaytlardan petabaytlargacha bo'lgan dataset'larni qo'llab-quvvatlaydi.
-
MongoDB Query Language (MQL) filtrlash, aggregation pipeline'lari, geospatial query'lar va full-text search'ni qo'llab-quvvatlaydi.
Cheklovlari
-
O'rnatilgan JOIN yo'q, shuning uchun collection'lararo query'lar bir nechta round-trip yoki denormalization'ni talab qiladi.
-
Uning moslashuvchanligi turli dasturchilar bitta collection'ga turli maydonlarni yozganda data consistency'ga sezdirmasdan putur yetkazishi ham mumkin.
-
Multi-document transaction'lar unumdorlikka qo'shimcha overhead qo'shadi. Document'lararo transaction'larga ehtiyojni minimallashtiradigan schema'larni loyihalashingiz kerak bo'ladi.
Wide-column ma'lumotlar bazalari
Wide-column ma'lumotlar bazalari ma'lumotlarni column family'larga ajratib tashkil qiladi. Ularda har bir row turli ma'lumot elementlari to'plamini saqlashi mumkin, saqlash esa distributed arxitektura yordamida bir nechta serverlar bo'ylab taqsimlanadi. Ular katta miqyosdagi ma'lumotlarni boshqarish uchun yaratilgan.
Mashhur wide-column ma'lumotlar bazalari: Apache Cassandra, Google Bigtable va Apache HBase. Eng mashhur wide-column ma'lumotlar bazasi bo'lgan Apache Cassandra juda katta hajmdagi yozish operatsiyalarini bajara olishi tufayli Apple, Netflix va Instagram kabi kompaniyalar tomonidan production'da ishlatiladi. U bunday hajmni single point of failure'siz bajara oladi — bunday workload moliyaviy ma'lumotlar va vaqt belgisiga ega boshqa yozuvlar ustidagi real-time analitikadan ham foyda ko'radi.
Wide-column ma'lumotlar bazalari qanday ishlaydi
Wide-column ma'lumotlar bazalari ma'lumotlarni partition key bo'yicha guruhlangan row'larga ajratib tashkil qiladi; partition key ma'lumotlar cluster'ning qayerida saqlanishini belgilaydi. Har bir partition ichida row'lar clustering key bo'yicha saralanadi, bu bog'liq yozuvlarni tartib bilan olishni osonlashtiradi. Relational ma'lumotlar bazalaridan farqli o'laroq, bitta jadvaldagi row'lar turli column'larni o'z ichiga olishi mumkin, shuning uchun har bir row faqat o'ziga kerak bo'lgan ma'lumotlarni saqlaydi.
Masalan, IoT sensor ko'rsatkichlarini saqlaydigan jadval device_id'ni partition key, timestamp'ni esa clustering key sifatida ishlatishi mumkin.
Partition: device_101

├── 10:00 → temperature: 25°C, humidity: 60%

├── 10:05 → temperature: 26°C

└── 10:10 → temperature: 27°C, pressure: 101 kPa
device_id'ni o'z ichiga olgan query o'sha qurilmaning barcha ko'rsatkichlarini tez olishi mumkin, chunki ma'lumotlar bazasi aynan qaysi partition'da qidirish kerakligini biladi. Keyin yangi ma'lumotlar log-structured merge-tree (LSM-tree) dizayni yordamida ketma-ket qo'shib boriladi, bu ma'lumotlar bazasiga sekinlashmasdan katta hajmdagi ma'lumotlar bilan ishlash imkonini beradi.
Kuchli tomonlari
-
Juda katta horizontal scaling uchun yaratilgan. Ko'proq node qo'shish yagona master node'ga tayanmasdan saqlash sig'imi va throughput'ni oshiradi.
-
Bir nechta node'lar bo'ylab data replication orqali high availability ta'minlanadi, bu esa bir yoki bir nechta node ishdan chiqqanda ham ma'lumotlar bazasiga so'rovlarga xizmat ko'rsatishni davom ettirish imkonini beradi.
-
IoT sensor ma'lumotlari, ilova log'lari, event stream'lar va time-series ma'lumotlari kabi asosan qo'shib yozishga (append) asoslangan workload'lar uchun optimallashtirilgan.
-
Tunable consistency'ni taqdim etadi: consistency, availability va latency o'rtasida muvozanat saqlash uchun o'qish yoki yozishni nechta replica tasdiqlashi kerakligini o'zingiz tanlashingiz mumkin.
Cheklovlari
-
Ilovangizning query pattern'lari atrofida schema'ni puxta loyihalashni talab qiladi. Ma'lumotlar yozilgandan keyin partition key'ni o'zgartirish odatda ma'lumotlarni migration qilishni talab qiladi.
-
Ad-hoc query'larni samarali qo'llab-quvvatlamaydi. Partition key yoki clustering key'dan foydalanmaydigan query'lar ko'pincha qimmatga tushadi.
-
Standart bo'yicha eventual consistency'dan foydalanadi, ya'ni sinxronizatsiya tugaguniga qadar replica'larda bir xil ma'lumotlarning turli versiyalari vaqtincha saqlanib turishi mumkin.
Graph ma'lumotlar bazalari
Graph ma'lumotlar bazalari ma'lumotlarni node'lar va edge'lar sifatida modellashtiradi: node biror entity'ni ifodalaydi, edge esa ikki node o'rtasidagi bog'lanishni ifodalaydi. Har bir edge'ning yo'nalishi bor va u property'larga ega bo'lishi mumkin. Graph ma'lumotlar bazalari ayniqsa bu bog'lanishlar bo'ylab samarali traverse qilishda ustunlik qiladi. Mashhur graph ma'lumotlar bazalari: Neo4j, TigerGraph, Amazon Neptune va JanusGraph. Tez o'sib borayotgan NoSQL segmentida Neo4j hamon eng keng qo'llaniladigan native graph ma'lumotlar bazasi bo'lib qolmoqda.
Graph ma'lumotlar bazalari qanday ishlaydi
Graph ma'lumotlar bazasidagi node'lar entity haqidagi property'larni saqlaydi, ularni bog'lovchi edge'lar esa node'lar o'rtasidagi bog'lanish haqidagi property'larni saqlaydi. Bu ma'lumotlar bazasiga bir nechta jadval bo'ylab row'larni moslashtirish o'rniga bir node'dan boshqasiga to'g'ridan-to'g'ri o'tish imkonini beradi.
Masalan, agar e-commerce graph'i uchun Neo4j'ning Cypher query tilidan foydalansangiz, u quyidagicha ko'rinadi:
MATCH (u:User)-[:PURCHASED]->(p:Product)-[:BELONGS_TO]->(c:Category)

WHERE u.id = 42

RETURN DISTINCT c.name
"42-foydalanuvchi sotib olgan mahsulotlarning kategoriyalarini top" kabi query bir nechta table join'larni bajarish o'rniga shunchaki User node'idan Product node'iga, so'ngra Category node'iga boradigan bog'lanishlar bo'ylab yuradi. Har bir node qo'shni node'larga to'g'ridan-to'g'ri havolalarni saqlagani sababli, graph ma'lumotlar bazalari graph o'sib borgan sari ham murakkab bog'lanishlarni samarali tahlil qila oladi.
Kuchli tomonlari
-
Relational ma'lumotlar bazasida 5-10 ta
JOINtalab qilishi mumkin bo'lgan murakkab bog'lanishli query'larni bitta graph traversal'ga soddalashtiradi. -
Telefon raqamlari, IP manzillar yoki qurilmalar kabi umumiy attribute'lar bo'ylab millionlab akkauntlarni millisekundlarda traverse qiladi, bu esa uni fraud detection tizimlari uchun ideal qiladi.
-
Recommendation engine'lar uchun samarali, chunki query'lar tabiiy graph traversal'lardan iborat.
-
Murakkab domain bilimlarini AI/ML ilovalari, supply chain bog'lanishlari yoki enterprise data catalog'lar uchun bog'langan graph sifatida ifodalashda samarali.
Cheklovlari
-
Juda katta graph'larga scale qilish arxitektura jihatidan murakkab, chunki bog'lanishlar shard chegaralarini kesib o'tadi.
-
Graph ma'lumotlar bazalari bog'lanishlarga ega bo'lmagan ma'lumotlar uchun mos emas. Agar ilovangiz entity'lar o'rtasidagi bog'lanishlarni kamdan-kam query qilsa, document yoki key-value ma'lumotlar bazasi soddaroq va tezroq bo'ladi.
-
Cypherkabi graph query tillarini o'rganishSQL'ga qaraganda qiyinroq va graph ma'lumotlar bazalari bo'yicha tajribaga ega muhandislarni topishSQLyokiMongoDBtajribasiga ega mutaxassislarni topishdan ko'ra qiyinroq.
NoSQL ma'lumotlar bazasining to'g'ri turini qanday tanlash kerak
Loyihangiz uchun to'g'ri NoSQL ma'lumotlar bazasi turi mashhurlik yoki siz topgan tutorial'da tasodifan nima ishlatilgani bilan belgilanmaydi. U quyidagi uchta savol bilan belgilanadi: ma'lumotlaringiz qanday shaklda, ilovangiz ularni qanday query qilishi kerak va scale talablari qanday.
Ma'lumotlaringiz shaklidan boshlang
Ma'lumotlar bazasi tanlovini toraytirishning eng tez usullaridan biri — unumdorlik, scalability yoki imkoniyatlar haqida o'ylashdan oldin ma'lumotlaringiz shakliga qarash. Har bir ma'lumotlar bazasi ma'lum turdagi ma'lumotlarni saqlash va query qilish uchun optimallashtirilgan, shuning uchun eng yaxshi ma'lumotlar bazasi odatda data model'i ilovangiz ma'lumotlariga eng yaxshi mos keladiganidir.
Buni quyidagicha o'ylab ko'rish mumkin:
-
Key-value ma'lumotlar bazasi: Agar ma'lumotlaringiz shakli har bir qiymat noyob identifikator bo'yicha olinadigan oddiy qidiruv bo'lsa, undan foydalaning. Bu eng yaxshi ishlaydi, chunki ular qiymatni uning key'i yordamida bir zumda olish uchun optimallashtirilgan.
-
Document ma'lumotlar bazasi: Agar ma'lumotlaringiz shakli nested maydonlar, massivlar yoki ixtiyoriy attribute'larga ega, o'z-o'zini to'liq tavsiflaydigan obyekt bo'lsa, undan foydalaning. Bunday ma'lumotlar bazalarida bog'liq ma'lumotlar bitta document'da joylashadi, bu vaqt o'tishi bilan o'zgarib boradigan
JSON'ga o'xshash ma'lumotlarni saqlashni osonlashtiradi. -
Wide-column ma'lumotlar bazasi: Agar ma'lumotlaringiz shakli umumiy identifikator bo'yicha guruhlangan va vaqt o'tishi bilan uzluksiz yozib boriladigan katta hajmdagi yozuvlardan iborat bo'lsa, undan foydalaning. Bunday ma'lumotlar bazalarida ma'lumotlar horizontal scaling uchun partition'larga ajratiladi va ketma-ket yozish uchun optimallashtiriladi.
-
Graph ma'lumotlar bazasi: Agar ma'lumotlaringiz shakli bog'lanishlar query'laringizning markazida turadigan, o'zaro bog'langan entity'lar tarmog'i bo'lsa, undan foydalaning. Bunday ma'lumotlar bazalari bog'lanishlarni join'lar orqali qayta tiklash o'rniga ular bo'ylab to'g'ridan-to'g'ri yuradi.
Query pattern'laringizni hisobga oling
Ilovangiz ma'lumotlarni qanday o'qishi ko'pincha ularni qanday saqlashidan muhimroq, ayniqsa NoSQL ma'lumotlar bazalarida. Avval domain'ni modellashtirib, keyinchalik kerakli ma'lumotlarni SQL join'lar qayta tiklashiga imkon beradigan relational ma'lumotlar bazalaridan farqli o'laroq, NoSQL schema'lari ilovaning o'qish pattern'lari atrofida loyihalanadi.
Qarorga quyidagicha yondashish mumkin:
-
Key-value ma'lumotlar bazasi: Agar query pattern'ingiz ma'lumotlarni bitta ma'lum identifikator bo'yicha olishni o'z ichiga olsa, buni ko'rib chiqing. Agar har bir so'rov "abc123 foydalanuvchi session'ini ol" yoki "cart_456 savatni olib kel" kabi ko'rinsa, sizga key-value ma'lumotlar bazasining o'zi yetarli.
-
Document ma'lumotlar bazasi: Agar query pattern'ingiz yozuvlar ichidagi maydonlar bo'yicha filtrlash, saralash yoki qidirishni o'z ichiga olsa, shuni tanlang. Bu turdagi ma'lumotlar bazasi bilan
category,priceyokicreated_atkabi maydonlarni query qilishingiz va bu qidiruvlarni tezlashtirish uchun index'lardan foydalanishingiz mumkin. -
Wide-column ma'lumotlar bazasi: Agar query pattern'laringiz ma'lumotlarni oldindan ma'lum partition key yordamida olsa, shuni tanlang. Query'lar partition key berilganda eng samarali bo'ladi, masalan, biror qurilmaning barcha sensor ko'rsatkichlarini yoki biror mijozning barcha tranzaksiyalarini olishda.
-
Graph ma'lumotlar bazasi: Agar query pattern'ingiz o'zaro bog'langan yozuvlar o'rtasidagi bog'lanishlarni o'rganishni o'z ichiga olsa, shunga to'xtaling. "X mahsulotni sotib olgan do'stlarning do'stlari" yoki "boshqa bo'limdagi menejerlarga bo'ysunadigan xodimlar" kabi query'lar chuqurligi noma'lum bo'lgan bog'lanishlar bo'ylab traverse qilishni o'z ichiga oladi.
Scale va consistency talablari
Hozirgi ehtiyojlaringizga javob beradigan va o'sish uchun joy qoldiradigan ma'lumotlar bazasini tanlash, sizda hech qachon bo'lmasligi ehtimoli katta bo'lgan workload'lar uchun loyihalashdan ko'ra yaxshiroq. Shuningdek, ilovangizdagi data consistency'ni ham hisobga oling. Ba'zi ma'lumotlar bazalari yozuvlarning bir zumda amalga oshishini ta'minlashdan ko'ra availability va write throughput'ni ustun qo'yadi.
Bu haqda o'ylashning amaliy usuli:
-
Key-value yoki Document ma'lumotlar bazasi: Agar ustuvor vazifangiz bitta serverdan tashqariga scale qilish bo'lsa, buni ko'rib chiqing. Ular horizontal scale qilish va aksariyat zamonaviy ilovalarning workload'larini bemalol ko'tarish uchun eng mos keladi.
-
Wide-column ma'lumotlar bazasi: Agar ustuvor vazifangiz juda katta hajmdagi yozish operatsiyalarini bajarish hamda og'ir yuklama ostida ham yuqori write throughput va availability'ni ta'minlash bo'lsa, buni ko'rib chiqing. U eng mos keladi, chunki event logging,
IoTtelemetriyasi va clickstream analitikasi kabi bitta mashina real ko'tara oladigan darajadan oshib ketadigan workload'lar uchun yaratilgan. -
Graph ma'lumotlar bazasi: Agar ustuvor vazifangiz o'zaro kuchli bog'langan ma'lumotlarni scale qilish bo'lsa, buni ko'rib chiqing. U node'lar o'rtasidagi to'g'ridan-to'g'ri bog'lanishlardan foydalanib bog'lanishlar bo'ylab traverse qilishda ayniqsa samarali, bu esa unga bitta mashinada milliardlab node va edge'lar bilan ishlash va shu bilan birga bog'lanishli query'larni tez bajarish imkonini beradi.
Yakun
Yagona "eng yaxshi" NoSQL ma'lumotlar bazasi yoki turi yo'q — faqat ilovangiz ma'lumotlari shakli, query pattern'lari va scalability talablariga eng yaxshi mos keladigani bor. Key-value ma'lumotlar bazalari o'ta tezkor qidiruvlarda ustunlik qiladi, document ma'lumotlar bazalari moslashuvchan JSON'ga o'xshash ma'lumotlar bilan oson ishlaydi, wide-column ma'lumotlar bazalari juda katta distributed workload'lar uchun yaratilgan, graph ma'lumotlar bazalari esa ma'lumotlar o'rtasidagi bog'lanishlar ilovangizning markazida turganda o'zini yaqqol namoyon qiladi.
NoSQL ecosystem'i rivojlanishda davom etmoqda: ArangoDB va Azure Cosmos DB kabi multi-model ma'lumotlar bazalari tobora ko'proq qo'llanilmoqda. Bitta ma'lumotlar bazasi ichida bir nechta data model'ni qo'llab-quvvatlash orqali ular turli workload'lar uchun alohida ma'lumotlar bazalarini boshqarishning operatsion overhead'ini kamaytiradi. Shu bilan birga, cloud-native ilovalar, AI va machine learning workload'lari hamda real-time tizimlarning o'sishda davom etishi NoSQL ma'lumotlar bazalarining yanada kengroq qo'llanilishiga turtki berishi kutilmoqda.
Qaysi ma'lumotlar bazasi turini tanlamang, bizning backend va data engineer roadmap'larimiz boshlash uchun ajoyib joy. Shuningdek, agar use case'ingiz uchun ma'lumotlar bazasini allaqachon bilsangiz, bizning maxsus MongoDB va Redis roadmap'larimiz yordam berishi mumkin. Agar hali qilmagan bo'lsangiz, texnologiyalar olamidagi yo'lingizni davom ettirar ekansiz, progress'ingizni kuzatish, o'rganish yo'llaringizni saqlash va shaxsiylashtirilgan roadmap'lardan foydalanish uchun roadmap.sh akkauntini yarating. Agar biror ma'lumotlar bazasi tushunchasini chuqurroq o'rganmoqchi yoki qo'shimcha savollar bermoqchi bo'lsangiz, AI Tutor ham xizmatingizda.
- Backend Developer Job Description in 2026
- Top 7 Backend Frameworks to Use in 2026: Pro Advice
- Top 10+ Backend Technologies to Use in 2026: Expert Advice
- 20 Backend Project Ideas to take you from Beginner to Pro
- 25 Essential Backend Development Tools for 2026
- 8 In-Demand Backend Developer Skills to Master
- The 5 Best Backend Development Languages to Master (2026)